Como Criar Pipelines Autônomos em Python Sem Complicar
Aprenda a evoluir scripts de automação para pipelines autônomos em Python usando agentes de IA de forma robusta, escalável e resiliente.
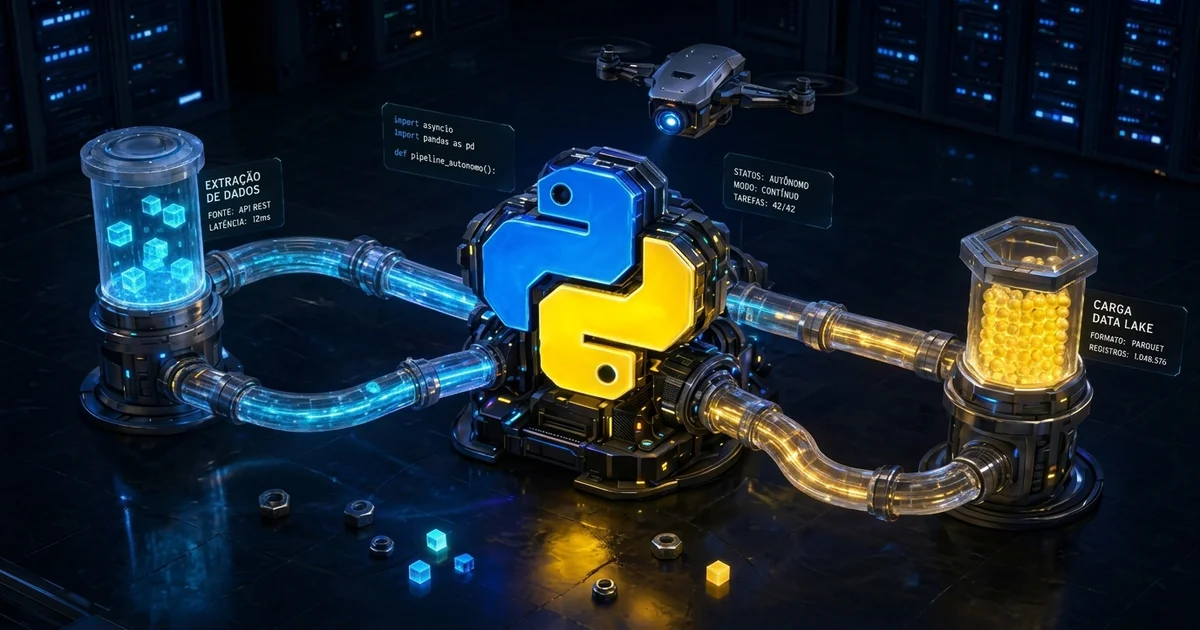
A transição de scripts determinísticos para pipelines autônomos em Python representa uma mudança fundamental no desenvolvimento de software moderno. Durante anos, a automação de processos dependeu exclusivamente de tarefas agendadas via cron, scripts de raspagem com regras fixas em Expressões Regulares e fluxos condicionais engessados. No entanto, quando o formato de uma fonte de dados muda levemente ou uma resposta de API externa vem inesperadamente fora do padrão, os scripts tradicionais falham silenciosamente ou interrompem a execução. Em ambientes de produção atuais, a introdução de modelos de linguagem e raciocínio dentro de pipelines de dados permite criar sistemas capazes de interpretar contexto, tomar decisões condicionais em tempo real e corrigir os próprios erros antes que uma falha chegue ao usuário final.
Construir um pipeline autônomo não significa substituir todo o código por chamadas desordenadas a Large Language Models (LLMs). Pelo contrário: a engenharia de software sólida exige que o LLM atue apenas nos pontos de incerteza e raciocínio dinâmico, enquanto a infraestrutura, o tratamento de tipos e a orquestração de I/O permanecem sob controle estrito do Python 3.14.7. Arquiteturas resilientes combinam a tipagem estática e validação rigorosa com a flexibilidade da tomada de decisão orientada a agentes.
Por que a automação tradicional baseada em scripts engessados falha?
Scripts condicionais tradicionais operam sob a premissa do determinismo absoluto. Se a entrada $A$ produzir a saída $B$, o sistema funciona perfeitamente. Contudo, em cenários reais de engenharia de dados, integração de sistemas legados e triagem de chamados, os dados quase nunca são estritamente determinísticos. Um e-mail de suporte pode conter uma solicitação de cancelamento escrita de dezenas de formas diferentes; um relatório em PDF pode alterar a ordem das suas colunas após uma atualização de software da fonte.
Tentar cobrir essas variações usando estruturas if/else encadeadas gera um código frágil e inmanutenível. Cada nova exceção exige um novo bloco condicional, criando uma dívida técnica gigante. Quando um elemento da página web muda de seletor CSS ou quando uma payload traz um tipo de dado imprevisto, o script quebra. O resultado é um ciclo interminável de manutenção reativa, no qual desenvolvedores gastam horas valiosas corrigindo scripts que falharam devido a pequenos ruídos nos dados de entrada.
Os pipelines autônomos resolvem esse problema introduzindo resiliência cognitiva. Em vez de dependerem de regras explícitas para cada caso de borda, eles utilizam agentes com capacidade de inferência para analisar o contexto do dado, selecionar a ferramenta adequada e validar se o resultado obtido atende aos critérios esperados antes de prosseguir no fluxo de execução.
Como estruturar pipelines autônomos em Python para evitar falhas em produção?
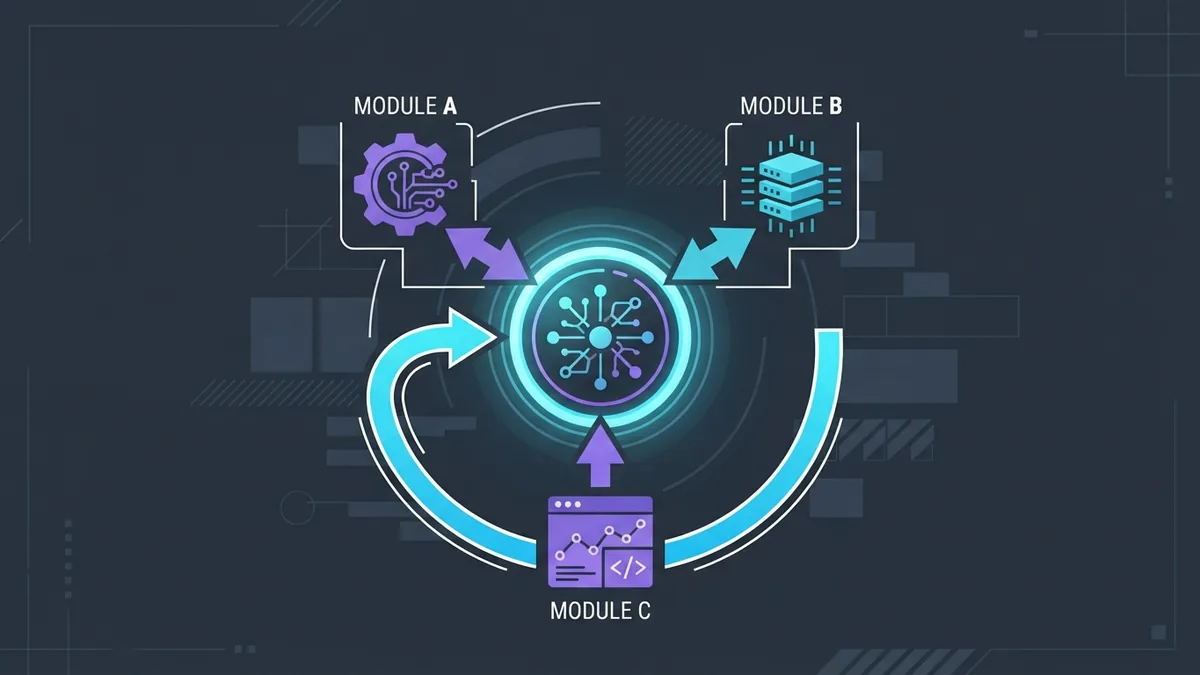
A construção de pipelines autônomos em Python exige um desacoplamento claro entre quatro camadas essenciais: a camada de contexto (estado), o orquestrador (agente de decisão), as ferramentas (funções Python puras) e as barreiras de proteção (guardrails). Sem essa separação, o pipeline se torna instável e imprevisível.
O estado do pipeline deve ser mantido de forma imutável ou controlada por esquemas de validação de dados rígidos. Usando bibliotecas como Pydantic e recursos nativos do Python 3.14.7, é possível definir modelos de dados que garantem que, independentemente da decisão tomada pelo agente, o formato final trafegado entre as etapas obedeça estritamente à interface esperada pelo restante do sistema.
from typing import Annotated, Literal
from pydantic import BaseModel, Field

class TaskAnalysis(BaseModel):
    intent: Literal["process_invoice", "escalate_support", "ignore"]
    confidence_score: float = Field(ge=0.0, le=1.0)
    reasoning: str
    extracted_entities: dict[str, str]

class PipelineState(BaseModel):
    raw_input: str
    analysis: TaskAnalysis | None = None
    execution_status: Literal["pending", "completed", "failed"] = "pending"
    retry_count: int = 0
A camada de decisão lê o estado atual, avalia os objetivos do pipeline e escolhe qual ferramenta (função) deve ser invocada. Se uma ferramenta retornar um erro tratável — por exemplo, uma falha de conexão temporária ou um formato de dado incompleto —, o agente recupera o erro dentro de um loop de reflexão, ajusta os parâmetros de entrada e tenta executar a tarefa novamente por um número limitado de vezes antes de sinalizar uma falha crítica.
Qual é a diferença entre um script linear e um agente autônomo?
Entender o ponto exato em que a automação simples deixa de ser suficiente e exige o uso de agentes com IA é essencial para não superdimensionar a arquitetura da sua aplicação. A tabela abaixo compara as características centrais de cada abordagem:
| Critério de Avaliação | Script Linear Tradicional | Workflow DAG (Ex: Airflow) | Pipeline Autônomo com Agente |
|---|---|---|---|
| Tomada de Decisão | Condicionais estáticos (if/else) |
Grafo acíclico dirigido fixo | Raciocínio dinâmico via LLM/LMM |
| Tratamento de Exceções | Falha imediata ou bloco try/except |
Reexecução da tarefa inteira | Autocorreção contextual e retentativa |
| Adaptabilidade a Dados | Exige esquema rígido e imutável | Tolera pequenas variações via código | Alta tolerância a dados não estruturados |
| Complexidade de Manutenção | Cresce exponencialmente com exceções | Alta para reestruturar grafos | Baixa para novas regras de negócio |
| Custo de Execução | Praticamente zero (CPU pura) | Baixo/Médio (infraestrutura) | Médio/Alto (consumo de tokens de API) |
Workflows DAG são excelentes para mover terabytes de dados quando os esquemas são previsíveis. No entanto, quando o pipeline precisa interagir com a API de um cliente que sofreu alterações, ler mensagens em linguagem natural ou navegar por sistemas legados onde a resposta muda dependendo do contexto empresarial, os agentes autônomos superam os workflows estáticos em flexibilidade e resiliência.
Como implementar a chamada de ferramentas e loops de decisão em Python?
Para implementar um loop de decisão robusto em Python sem se prender a abstrações opacas de frameworks externos, podemos construir uma estrutura orientada a chamadas de funções (tool calling). Esse padrão garante transparência total sobre o que o agente está executando e facilita a escrita de testes unitários determinísticos.
No exemplo a seguir, definimos ferramentas isoladas como funções tipadas em Python e criamos um orquestrador que executa o loop de raciocínio-ação-observação:
import json
import logging
from typing import Callable, Any

logging.basicConfig(level=logging.INFO)
logger = logging.getLogger("AgentPipeline")

def fetch_customer_data(customer_id: str) -> dict[str, Any]:
    """Busca dados cadastrais do cliente no banco de dados."""
    # Simulação de busca no banco de dados
    logger.info(f"Executando fetch_customer_data para ID: {customer_id}")
    return {"id": customer_id, "status": "active", "tier": "enterprise"}

def calculate_discount(tier: str, base_price: float) -> float:
    """Calcula o desconto aplicável com base no nível do cliente."""
    logger.info(f"Calculando desconto para nível: {tier}")
    if tier == "enterprise":
        return base_price * 0.20
    return base_price * 0.05

class AutonomousOrchestrator:
    def __init__(self):
        self.tools: dict[str, Callable[..., Any]] = {
            "fetch_customer_data": fetch_customer_data,
            "calculate_discount": calculate_discount
        }

    def execute_tool(self, tool_name: str, arguments: dict[str, Any]) -> str:
        if tool_name not in self.tools:
            raise ValueError(f"Ferramenta '{tool_name}' não registrada.")
        try:
            result = self.tools[tool_name](**arguments)
            return json.dumps({"status": "success", "data": result})
        except Exception as e:
            logger.error(f"Erro ao executar {tool_name}: {e}")
            return json.dumps({"status": "error", "message": str(e)})

    def run_pipeline(self, initial_payload: dict[str, Any]) -> None:
        logger.info("Iniciando pipeline autônomo...")
        # O agente decide a sequência de ferramentas a invocar com base no contexto
        customer_id = initial_payload.get("customer_id")

        # Passo 1: Execução da primeira ferramenta selecionada pelo agente
        raw_data = self.execute_tool("fetch_customer_data", {"customer_id": customer_id})
        data_obj = json.loads(raw_data)

        if data_obj.get("status") == "success":
            tier = data_obj["data"]["tier"]
            # Passo 2: O agente interpreta o resultado anterior e chama a próxima etapa
            discount_result = self.execute_tool("calculate_discount", {"tier": tier, "base_price": 1000.0})
            logger.info(f"Resultado final do pipeline: {discount_result}")
        else:
            logger.warning("Pipeline interrompido devido a erro na busca de dados.")

if __name__ == "__main__":
    orchestrator = AutonomousOrchestrator()
    orchestrator.run_pipeline({"customer_id": "usr_9823"})
O trecho acima demonstra a mecânica interna de despacho de ferramentas. Em um sistema com IA integrada, a escolha do nome do método (tool_name) e dos argumentos (arguments) é feita pela inferência do modelo a partir do schema JSON exposto pela aplicação, enquanto a execução real acontece em ambiente controlado dentro da sua infraestrutura Python.
Como garantir resiliência, monitoramento e rastreabilidade no pipeline?
Trabalhar com componentes não determinísticos dentro de sistemas autônomos introduz desafios críticos de observabilidade. Se um agente decide alterar o fluxo padrão de processamento de um lote de dados, o desenvolvedor precisa saber exatamente o porquê dessa decisão, qual foi a chamada de API efetuada e qual foi o consumo financeiro e computacional envolvido.
Para manter o controle sobre pipelines em produção, aplique as seguintes práticas indispensáveis de engenharia:
- Structured Logging e Tracing: Utilize bibliotecas como OpenTelemetry para gerar rastros contínuos de cada iteração do loop do agente. Registre o prompt enviado, a resposta bruta da API, as ferramentas chamadas e os tempos de resposta de cada etapa.
- Limites Rígidos de Interação (Guardrails): Estabeleça um limite máximo de iterações por execução (por exemplo, no máximo 5 chamadas de ferramentas por tarefa). Isso impede que o agente entre em um loop infinito de tentativas e cause um estouro de cota nas APIs de LLM.
- Controle de Custos e Latência: Implemente mecanismos de caching local para resultados de chamadas de inferência idênticas. Se o pipeline processa entradas repetidas, o cache evita recalcular embeddings ou reexecutar prompts dispendiosos.
- Mecanismo Fallback Humano (Human-in-the-Loop): Quando a pontuação de confiança do agente para uma tomada de decisão ficar abaixo de um limiar pré-definido (ex: 75%), o pipeline deve pausar o processamento, persistir o estado no banco de dados e notificar um operador humano via webhook para aprovação manual.
Adotando essas barreiras técnicas, o pipeline ganha autonomia para resolver problemas conhecidos e variações menores de dados, sem colocar em risco a integridade dos bancos de dados ou estourar orçamentos operacionais.
A transição da automação tradicional para sistemas inteligentes não exige abandonar as boas práticas de código nem reescrever toda a sua infraestrutura do zero. Ao combinar a tipagem forte do Python com validações rigorosas e loops de decisão isolados, você consegue construir pipelines autônomos em Python capazes de evoluir com as demandas da sua infraestrutura, garantindo resiliência, baixa manutenção e alta confiabilidade em produção.