Cómo Crear Pipelines Autónomos en Python sin Complicaciones
Aprende a evolucionar tus scripts a pipelines autónomos en Python con agentes de IA de forma robusta, escalable y resiliente en producción.
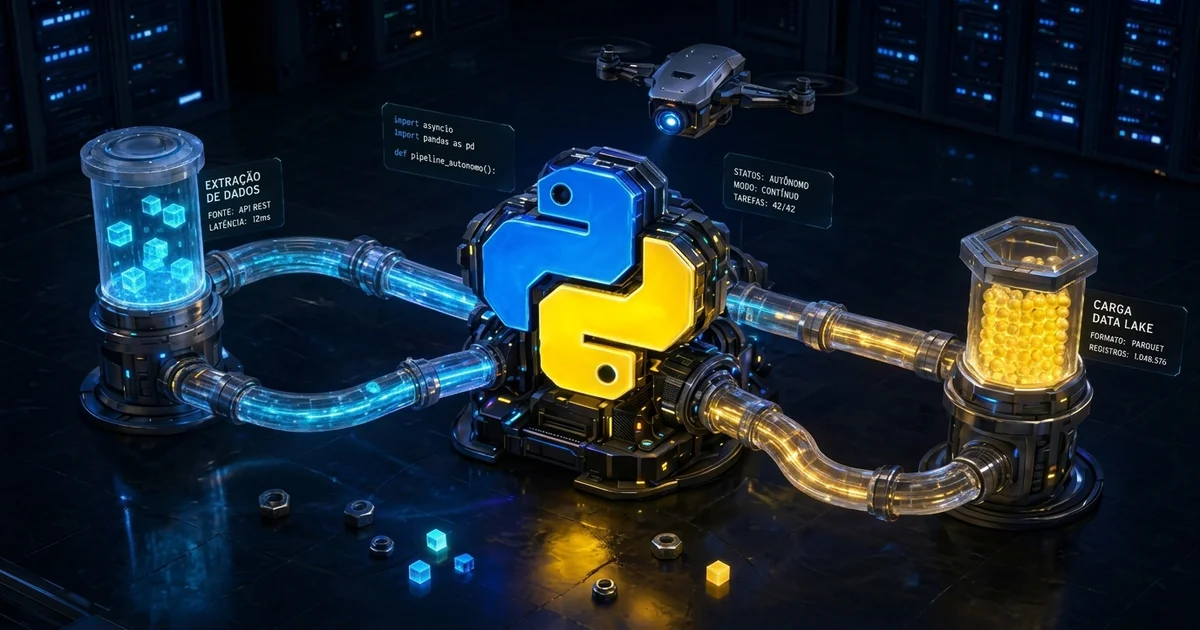
La transición de scripts deterministas a pipelines autónomos en Python representa un cambio fundamental en el desarrollo de software moderno. Durante años, la automatización de procesos dependió exclusivamente de tareas programadas mediante cron, scripts de extracción con reglas fijas en Expresiones Regulares y flujos condicionales rígidos. Sin embargo, cuando el formato de una fuente de datos cambia ligeramente o una respuesta de una API externa llega inesperadamente fuera del estándar, los scripts tradicionales fallan silenciosamente o interrumpen su ejecución. En los entornos de producción actuales, la integración de modelos de lenguaje y razonamiento dentro de los pipelines de datos permite crear sistemas capaces de interpretar el contexto, tomar decisiones condicionales en tiempo real y corregir sus propios errores antes de que un fallo llegue al usuario final.
Construir un pipeline autónomo no significa reemplazar todo el código con llamadas desordenadas a Grandes Modelos de Lenguaje (LLMs). Por el contrario: una sólida ingeniería de software exige que el LLM actúe únicamente en los puntos de incertidumbre y razonamiento dinámico, mientras que la infraestructura, la validación de tipos y la orquestación de E/S permanecen bajo el control estrito de Python 3.14.7. Las arquitecturas resilientes combinan el tipado estático y la validación rigurosa con la flexibilidad de la toma de decisiones orientada a agentes.
¿Por qué falla la automatización tradicional basada en scripts rígidos?
Los scripts condicionales tradicionales operan bajo la premisa del determinismo absoluto. Si la entrada $A$ produce la salida $B$, el sistema funciona a la perfección. Sin embargo, en escenarios reales de ingeniería de datos, integración de sistemas heredados y clasificación de tickets de soporte, los datos casi nunca son estrictamente deterministas. Un correo electrónico de soporte puede contener una solicitud de cancelación escrita de docenas de formas distintas; un informe en PDF puede cambiar el orden de sus columnas tras una actualización del software de la fuente.
Intentar cubrir estas variaciones utilizando estructuras if/else encadenadas genera un código frágil e inmantenible. Cada nueva excepción exige un nuevo bloque condicional, lo que acumula una deuda técnica gigantesca. Cuando un elemento de una página web cambia de selector CSS o cuando un payload incluye un tipo de dato imprevisto, el script se rompe. El resultado es un ciclo interminable de mantenimiento reactivo, donde los desarrolladores gastan horas valiosas corrigiendo scripts que fallaron debido a pequeños ruidos en los datos de entrada.
Los pipelines autónomos resuelven este problema introduciendo resiliencia cognitiva. En lugar de depender de reglas explícitas para cada caso límite, utilizan agentes con capacidad de inferencia para analizar el contexto de los datos, seleccionar la herramienta adecuada y validar si el resultado obtenido cumple con los criterios esperados antes de continuar con el flujo de ejecución.
¿Cómo estructurar pipelines autónomos en Python para evitar fallos en producción?
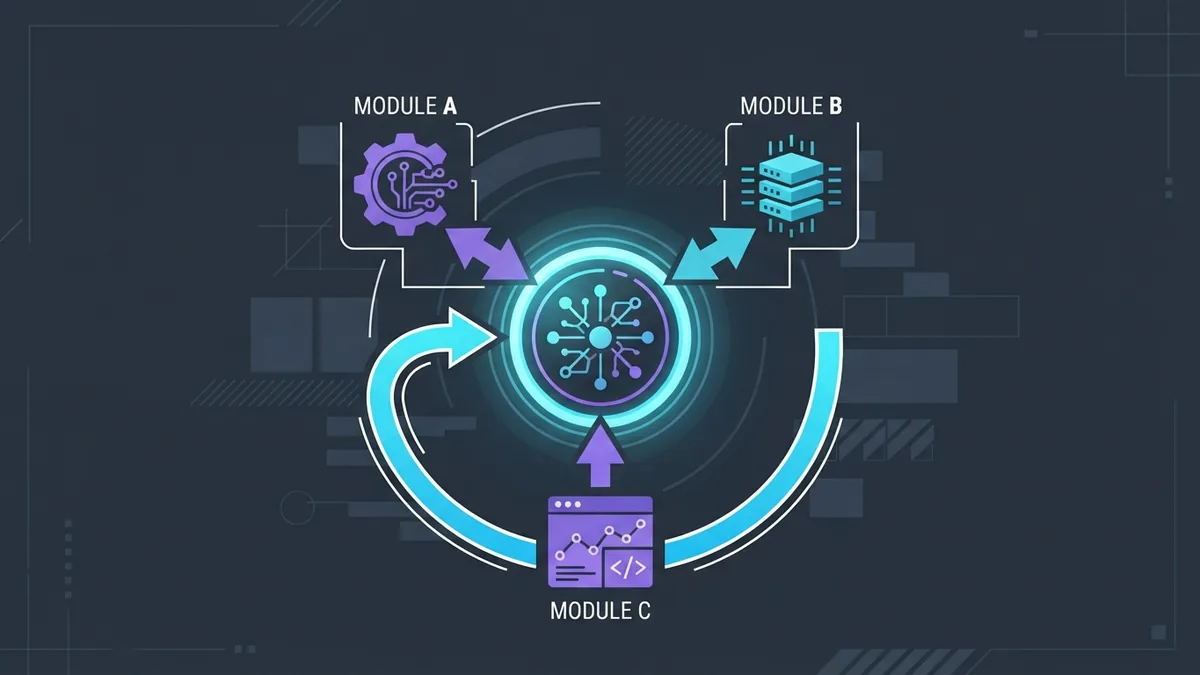
La construcción de pipelines autónomos en Python exige una clara separación entre cuatro capas esenciales: la capa de contexto (estado), el orquestador (agente de decisión), las herramientas (funciones puras de Python) y las barreras de protección (guardrails). Sin esta separación, el pipeline se vuelve inestable e impredecible.
El estado del pipeline debe mantenerse de forma inmutable o controlarse mediante esquemas rígidos de validación de datos. Utilizando librerías como Pydantic y características nativas de Python 3.14.7, es posible definir modelos de datos que garanticen que, independientemente de la decisión tomada por el agente, el formato final transferido entre las etapas cumpla estrictamente con la interfaz esperada por el resto del sistema.
from typing import Annotated, Literal
from pydantic import BaseModel, Field

class TaskAnalysis(BaseModel):
    intent: Literal["process_invoice", "escalate_support", "ignore"]
    confidence_score: float = Field(ge=0.0, le=1.0)
    reasoning: str
    extracted_entities: dict[str, str]

class PipelineState(BaseModel):
    raw_input: str
    analysis: TaskAnalysis | None = None
    execution_status: Literal["pending", "completed", "failed"] = "pending"
    retry_count: int = 0
La capa de decisión lee el estado actual, evalúa los objetivos del pipeline y elige qué herramienta (función) debe ser invocada. Si una herramienta devuelve un error manejable —por ejemplo, un fallo de conexión temporal o un formato de datos incompleto—, el agente recupera el error dentro de un bucle de reflexión, ajusta los parámetros de entrada y vuelve a intentar ejecutar la tarea un número limitado de veces antes de señalar un fallo crítico.
¿Cuál es la diferencia entre un script lineal y un agente autónomo?
Comprender el punto exacto en el que la automatización simple deja de ser suficiente y requiere el uso de agentes con IA es esencial para no sobredimensionar la arquitectura de tu aplicación. La siguiente tabla compara las características centrales de cada enfoque:
| Criterio de Evaluación | Script Lineal Tradicional | Workflow DAG (Ej: Airflow) | Pipeline Autónomo con Agente |
|---|---|---|---|
| Toma de Decisiones | Condicionales estáticos (if/else) |
Grafo acíclico dirigido fijo | Razonamiento dinámico vía LLM/LMM |
| Manejo de Excepciones | Fallo inmediato o bloque try/except |
Reejecución de toda la tarea | Autocorrección contextual y reintento |
| Adaptabilidad a los Datos | Requiere esquema rígido e inmutable | Tolera pequeñas variaciones vía código | Alta tolerancia a datos no estructurados |
| Complejidad de Mantenimiento | Crece exponencialmente con excepciones | Alta para reestructurar grafos | Baja para nuevas reglas de negocio |
| Costo de Ejecución | Prácticamente cero (CPU pura) | Bajo/Medio (infraestructura) | Medio/Alto (consumo de tokens de API) |
Los workflows DAG son excelentes para mover terabytes de datos cuando los esquemas son predecibles. Sin embargo, cuando el pipeline necesita interactuar con la API de un cliente que ha sufrido cambios, interpretar mensajes en lenguaje natural o navegar por sistemas heredados donde la respuesta cambia según el contexto empresarial, los agentes autónomos superan a los workflows estáticos en flexibilidad y resiliencia.
¿Cómo implementar la llamada a herramientas y bucles de decisión en Python?
Para implementar un bucle de decisión robusto en Python sin quedar atrapado en abstracciones opacas de frameworks externos, podemos construir una estructura orientada a llamadas de funciones (tool calling). Este patrón garantiza transparencia total sobre lo que el agente está ejecutando y facilita la escritura de pruebas unitarias deterministas.
En el siguiente ejemplo, definimos herramientas aisladas como funciones tipadas en Python y creamos un orquestador que ejecuta el bucle de razonamiento-acción-observación:
import json
import logging
from typing import Callable, Any

logging.basicConfig(level=logging.INFO)
logger = logging.getLogger("AgentPipeline")

def fetch_customer_data(customer_id: str) -> dict[str, Any]:
    """Busca datos catastrales del cliente en la base de datos."""
    # Simulación de búsqueda en la base de datos
    logger.info(f"Executando fetch_customer_data para ID: {customer_id}")
    return {"id": customer_id, "status": "active", "tier": "enterprise"}

def calculate_discount(tier: str, base_price: float) -> float:
    """Calcula el descuento aplicable según el nivel del cliente."""
    logger.info(f"Calculando desconto para nível: {tier}")
    if tier == "enterprise":
        return base_price * 0.20
    return base_price * 0.05

class AutonomousOrchestrator:
    def __init__(self):
        self.tools: dict[str, Callable[..., Any]] = {
            "fetch_customer_data": fetch_customer_data,
            "calculate_discount": calculate_discount
        }

    def execute_tool(self, tool_name: str, arguments: dict[str, Any]) -> str:
        if tool_name not in self.tools:
            raise ValueError(f"Ferramenta '{tool_name}' não registrada.")
        try:
            result = self.tools[tool_name](**arguments)
            return json.dumps({"status": "success", "data": result})
        except Exception as e:
            logger.error(f"Erro ao executar {tool_name}: {e}")
            return json.dumps({"status": "error", "message": str(e)})

    def run_pipeline(self, initial_payload: dict[str, Any]) -> None:
        logger.info("Iniciando pipeline autônomo...")
        # El agente decide la secuencia de herramientas a invocar con base en el contexto
        customer_id = initial_payload.get("customer_id")

        # Paso 1: Ejecución de la primera herramienta seleccionada por el agente
        raw_data = self.execute_tool("fetch_customer_data", {"customer_id": customer_id})
        data_obj = json.loads(raw_data)

        if data_obj.get("status") == "success":
            tier = data_obj["data"]["tier"]
            # Paso 2: El agente interpreta el resultado anterior y llama a la siguiente etapa
            discount_result = self.execute_tool("calculate_discount", {"tier": tier, "base_price": 1000.0})
            logger.info(f"Resultado final do pipeline: {discount_result}")
        else:
            logger.warning("Pipeline interrompido devido a erro na busca de dados.")

if __name__ == "__main__":
    orchestrator = AutonomousOrchestrator()
    orchestrator.run_pipeline({"customer_id": "usr_9823"})
El fragmento anterior demuestra la mecánica interna del despacho de herramientas. En un sistema con IA integrada, la elección del nombre del método (tool_name) y de los argumentos (arguments) la realiza la inferencia del modelo a partir del esquema JSON expuesto por la aplicación, mientras que la ejecución real ocurre en un entorno controlado dentro de tu infraestructura de Python.
¿Cómo garantizar resiliencia, monitoreo y trazabilidad en el pipeline?
Trabajar con componentes no deterministas dentro de sistemas autónomos introduce desafíos críticos de observabilidad. Si un agente decide alterar el flujo predeterminado de procesamiento de un lote de datos, el desarrollador necesita entender exactamente el porqué de esa decisión, qué llamada a la API se realizó y cuál fue el consumo financiero y computacional involucrado.
Para mantener el control sobre los pipelines en producción, aplica las siguientes prácticas indispensables de ingeniería:
- Structured Logging y Tracing: Utiliza librerías como OpenTelemetry para generar trazas continuas de cada interacción del bucle del agente. Registra el prompt enviado, la respuesta en bruto de la API, las herramientas invocadas y los tiempos de respuesta de cada etapa.
- Límites Rígidos de Interacción (Guardrails): Establece un límite máximo de iteraciones por ejecución (por ejemplo, un máximo de 5 llamadas a herramientas por tarea). Esto evita que el agente entre en un bucle infinito de reintentos y supere la cuota de las API de LLM.
- Control de Costos y Latencia: Implementa mecanismos de caching local para los resultados de llamadas de inferencia idénticas. Si el pipeline procesa entradas repetidas, la caché evita recalcular embeddings o reejecutar prompts costosos.
- Mecanismo Fallback Humano (Human-in-the-Loop): Cuando el puntaje de confianza del agente para tomar una decisión caiga por debajo de un umbral predefinido (por ejemplo, el 75%), el pipeline debe pausar el procesamiento, persistir el estado en la base de datos y notificar a un operador humano mediante un webhook para aprobación manual.
Al adoptar estas barreras técnicas, el pipeline obtiene autonomía para resolver problemas conocidos y pequeñas variaciones de datos, sin poner en riesgo la integridad de las bases de datos ni sobrepasar los presupuestos operativos.
La transición de la automatización tradicional a sistemas inteligentes no exige abandonar las buenas prácticas de código ni reescribir toda tu infraestructura desde cero. Al combinar el tipado fuerte de Python con validaciones rigurosas y bucles de decisión aislados, logras construir pipelines autónomos en Python capaces de evolucionar con las demandas de tu infraestructura, garantizando resiliencia, bajo mantenimiento y alta confiabilidad en producción.