Fuga de memoria en python: resuélvela con Memray
Aprende a detectar y solucionar cualquier fuga de memoria en python con Memray para mantener tus contenedores estables y evitar caídas en producción.
Cuando un servicio backend entra en un ciclo de consumo progresivo de RAM hasta ser aniquilado por el OOM Killer de la máquina virtual, la causa más probable es una fuga de memoria en python. A diferencia de lenguajes como C o C++, donde la pérdida de memoria proviene del olvido explícito de liberar punteros por parte del programador, en el ecosistema Python el problema adopta una forma más sutil. En la versión 3.14.7 del intérprete, la fuga ocurre casi siempre por la retención involuntaria de referencias activas en el gráfico de objetos de la aplicación, lo que impide que el recolector de basura limpie la estructura.
Cuando un proceso consume cientos de megabytes más de lo previsto, programar reinicios periódicos en Kubernetes o en systemd funciona solo como un paño de agua tibia temporal y peligroso. Para solucionar el problema de raíz, es necesario comprender la arquitectura del administrador de memoria de CPython, aislar los cuellos de botella de asignación mediante herramientas especializadas de perfilado y reestructurar los patrones de código que impiden la eliminación automática de las estructuras de datos.
¿Por qué la memoria del proceso Python sigue creciendo en producción?
El intérprete CPython utiliza un sistema híbrido de gestión de memoria basado primordialmente en el conteo de referencias (reference counting), complementado por un recolector de basura cíclico (cyclic garbage collector). Cada objeto en Python tiene un encabezado PyObject que almacena su tipo y el número actual de referencias que apuntan hacia él. En cuanto este conteo llega a cero, CPython desasigna la memoria del objeto de inmediato.
El problema surge cuando referencias no deseadas permanecen activas en ámbitos de larga duración. Si se inserta un objeto en una lista global, en un diccionario de módulo, en un atributo de clase o dentro del cierre (closure) de una función de larga vida, su contador de referencias nunca llegará a cero. En consecuencia, el intérprete asume que ese bloque de datos sigue siendo útil y se niega a descartarlo.
Además, el asignador interno de CPython, llamado pymalloc, gestiona bloques pequeños de memoria divididos en arenas, pools y blocks. Cuando Python libera la memoria de un objeto interno, esa memoria con frecuencia regresa al pool interno de pymalloc y no directamente al sistema operativo. Este comportamiento genera fragmentación de la memoria física (Resident Set Size - RSS), haciendo que el proceso parezca retener RAM incluso después de ejecutar operaciones pesadas.
Para empeorar el escenario, las bibliotecas escritas en extensiones C, Rust o C++ integradas en Python pueden asignar memoria nativa mediante malloc directamente en el heap del sistema. El Garbage Collector de CPython es completamente ciego a estas asignaciones nativas, volviendo invisibles las fugas provocadas por bindings mal implementados o por manipuladores de archivos y conexiones que no cierran sus punteros de bajo nivel.
¿Cómo identificar una fuga de memoria en python en la práctica?
Diagnosticar retenciones de memoria inspeccionando el código a simple vista es una tarea ineficiente. Aunque el módulo nativo tracemalloc ayuda en escenarios sencillos, agrega una sobrecarga de ejecución considerable y no puede monitorear asignaciones nativas realizadas fuera del intérprete CPython. La solución moderna y de altísima precisión para este análisis es Memray, un perfilador de memoria desarrollado específicamente para aplicaciones Python.
Memray es capaz de rastrear asignaciones tanto a nivel del intérprete Python como en las extensiones nativas en C. Registra cada instrucción de asignación de memoria con un impacto mínimo en el rendimiento, lo que te permite ejecutar el perfilador directamente en entornos de pruebas o incluso en réplicas controladas de producción.
Para iniciar el análisis, instala Memray mediante el gestor de paquetes y prepara el script que presente el síntoma de crecimiento continuo en el consumo de RAM:
pip install memray
Considera la siguiente aplicación de ejemplo, que simula una fuga clásica generada por el acumulamiento del historial de peticiones en una lista mantenida en memoria global sin descarte:
import time

# Simulación de un registro global de auditoría sin límite de tamaño
HISTORICO_REQUISICOES = []

class PayloadProcessado:
    def __init__(self, identificador: int, dados: bytes):
        self.identificador = identificador
        self.dados = dados

def processar_requisicao(indice: int) -> None:
    # Crea un búfer sustancial de 1 MB para cada llamada
    conteudo = bytes(1024 * 1024)
    payload = PayloadProcessado(identificador=indice, dados=conteudo)

    # Error de arquitectura: el objeto se retiene globalmente para siempre
    HISTORICO_REQUISICOES.append(payload)

def executar_servico() -> None:
    for i in range(100):
        processar_requisicao(i)
        time.sleep(0.01)

if __name__ == "__main__":
    executar_servico()
Grabando el perfil de asignación con Memray CLI
Para capturar el perfil completo de asignación del script sin alterar una sola línea del código fuente, ejecuta el comando memray run en tu terminal. Agrega el parámetro --native siempre que sospeches de fugas en bibliotecas C nativas como NumPy, Pandas o controladores de bases de datos:
python -m memray run --native -o perfil_memoria.bin meu_script.py
Al finalizar la ejecución, Memray genera un archivo binario que contiene el árbol completo de asignaciones y liberaciones de memoria a lo largo del tiempo. El siguiente paso consiste en convertir esos datos brutos en una visualización clara.
Analizando el Flamegraph para encontrar la línea exacta
El formato más eficiente para interpretar los datos de Memray es el gráfico de llama (flamegraph). Ejecuta el comando para generar el informe HTML a partir del archivo binario creado:
python -m memray flamegraph perfil_memoria.bin -o relatorio.html
Abre el archivo relatorio.html en cualquier navegador web. La interfaz interactiva mostrará barras horizontales donde el ancho de cada bloque representa la cantidad total de memoria asignada por una función determinada. Al inspeccionar la parte superior de la pila de llamas, identificarás la línea exacta del código donde se asignó y retuvo la memoria, permitiéndote rastrear el trayecto del dato en el código hasta el punto de estancamiento.
¿Cuáles son los patrones de código que más causan retención involuntaria?
El análisis de los informes de los perfiladores revela que la gran mayoría de las fugas en Python provienen de tres patrones de implementación recurrentes. Conocer la mecánica interna de estos errores evita que se introduzcan en la base de código durante la fase de desarrollo.
| Patrón de error | Mecanismo de la fuga | Impacto en producción |
|---|---|---|
| Caché sin expiración | Objetos almacenados en diccionarios globales sin limitación de tamaño (LRU) | Crecimiento lineal e infinito del RSS hasta la caída del sistema |
Referencias circulares con __del__ |
Objetos cruzados impiden el conteo cero y sobrecargan la limpieza cíclica | Acumulación de objetos obsoletos en la memoria heap |
| Listeners y Callbacks | Los eventos registran referencias fuertes a métodos de instancias que deberían descartarse | Evita la liberación de árboles enteros de objetos |
El primer patrón es el uso incorrecto de decoradores de almacenamiento en caché. Cuando el decorador @functools.lru_cache se aplica sin el argumento maxsize (o se configura como maxsize=None), almacena indefinidamente el resultado de cada llamada con parámetros únicos. Si tu aplicación recibe peticiones de usuarios con parámetros altamente dinámicos (como UUIDs o marcas de tiempo), el caché crecerá indefinidamente hasta agotar la RAM de la computadora host.
El segundo patrón es la aparición de referencias circulares en estructuras de datos complejas. Ocurre cuando el objeto A mantiene una referencia hacia el objeto B, y el objeto B guarda una referencia de vuelta hacia el objeto A. El algoritmo de conteo de referencias de Python falla en estos casos porque el conteo de ambos nunca llega a cero por sí solo. Aunque el Garbage Collector cíclico de CPython está diseñado para identificar y romper estos ciclos, la presencia del método finalizador __del__ o dependencias de módulos C puede impedir la liberación automática.
El tercer patrón involucra la retención por medio de registradores de eventos o manejadores de señales (signal handlers). Cuando una instancia de clase registra uno de sus métodos como callback en un bus de eventos de larga duración o en una biblioteca gráfica, el bus conserva una referencia fuerte hacia la instancia completa. Aunque el resto de la aplicación pierda la referencia de ese objeto, el manejador de eventos impedirá que la memoria se limpie.
¿Cómo corregir cada patrón de fuga y validar la solución?
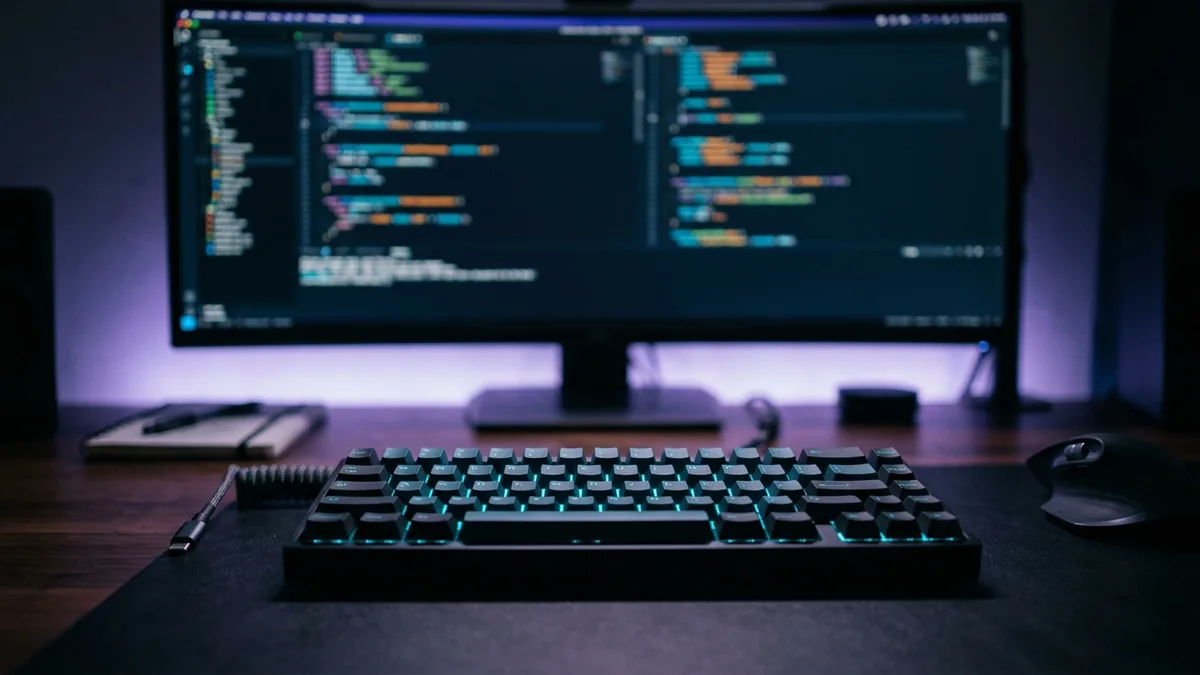
Para erradicar la retención no deseada de memoria, debemos adoptar técnicas de refactorización enfocadas en el control de ámbito y el uso de referencias débiles. La regla de oro consiste en reemplazar los cachés ilimitados por estructuras con políticas de descarte definidas o tablas de referencias débiles mediante el módulo nativo weakref.
Si la intención de tu código es mantener instancias almacenadas en caché únicamente mientras otras partes de la aplicación las estén utilizando, usa un weakref.WeakValueDictionary. Esta estructura de datos no incrementa el contador de referencias fuertes del objeto, permitiendo que el Garbage Collector limpie la instancia en cuanto salga del ámbito principal:
import weakref
import gc

class ObjetoPesado:
    def __init__(self, chave: str):
        self.chave = chave
        self.dados = bytearray(10 * 1024 * 1024)  # 10 MB

class GerenciadorCacheRefatorado:
    def __init__(self):
        # WeakValueDictionary no impide la desasignación por el Garbage Collector
        self._cache: weakref.WeakValueDictionary[str, ObjetoPesado] = weakref.WeakValueDictionary()

    def obter_objeto(self, chave: str) -> ObjetoPesado:
        obj = self._cache.get(chave)
        if obj is None:
            obj = ObjetoPesado(chave)
            self._cache[chave] = obj
        return obj

def testar_comportamento_memoria():
    cache = GerenciadorCacheRefatorado()

    # Creación dentro de un ámbito temporal
    def escopo_temporario():
        item = cache.obter_objeto("sessao_123")
        print(f"Objeto en uso dentro del ámbito. Elementos en el caché: {len(cache._cache)}")

    escopo_temporario()

    # Fuerza la recolección de basura cíclica para validar la liberación inmediata
    gc.collect()

    print(f"Tras salir del ámbito local. Elementos restantes en el caché: {len(cache._cache)}")

if __name__ == "__main__":
    testar_comportamento_memoria()
Otra refactorización esencial implica reemplazar el cargado integral de colecciones por un procesamiento continuo mediante generadores (generators) u iteradores. En lugar de leer un archivo pesado o una consulta masiva de PostgreSQL 18.6 hacia una lista en memoria, estructura el pipeline para consumir registros en lotes mediante la instrucción yield:
from typing import Iterator

def ler_registros_grandes(caminho_arquivo: str) -> Iterator[str]:
    """Procesa archivos de gigabytes línea por línea sin inflar el RSS del proceso."""
    with open(caminho_arquivo, mode="r", encoding="utf-8") as arquivo:
        for linha in arquivo:
            # Procesa y cede el dato individualmente sin cargar todo en la RAM
            yield linha.strip()

def processar_pipeline(caminho: str) -> None:
    for registro in ler_registros_grandes(caminho):
        # Operación directa sobre el dato individual
        pass
Por último, para validar que la corrección haya tenido efecto, ejecuta Memray utilizando la opción de comparación de informes (diff). Graba la ejecución de la versión anterior de tu servicio y la de la nueva versión refactorizada para obtener una comparación directa:
python -m memray run -o perfil_antigo.bin versao_antiga.py
python -m memray run -o perfil_novo.bin versao_nova.py
python -m memray stats perfil_novo.bin
El comando stats mostrará el número total de asignaciones realizadas, el pico de consumo de memoria (peak memory usage) y el tamaño total asignado. La comparación garantizará que la gráfica de consumo de RAM alcance una meseta estable en lugar de presentar una rampa ascendente a lo largo del tiempo de operación.
Conclusión
Dominar el análisis y la eliminación de cuellos de botella en la gestión de memoria es un requisito indispensable para mantener aplicaciones Python escalables y resilientes en producción. Al comprender cómo interactúan el conteo de referencias y la asignación nativa con el sistema operativo, dejas de depender de reinicios paliativos en tus contenedores para adoptar un enfoque verdaderamente diagnóstico.
Herramientas modernas como Memray transforman el proceso de perfilado en una tarea determinista, revelando al instante la línea exacta de código responsable de la retención de datos. Integrar estas pruebas de perfilado en tu flujo de integración continua es el camino definitivo para erradicar cualquier fuga de memoria en python de tu entorno de producción.