Vazamento de memória em python: como resolver com Memray
Aprenda a rastrear e eliminar qualquer vazamento de memória em python usando o profiler Memray para manter seu container estável e evitar quedas em produção.
Quando um serviço backend entra em um ciclo de consumo progressivo de RAM até ser dizimado pelo OOM Killer da máquina virtual, a causa mais provável é um vazamento de memória em python. Diferente de linguagens como C ou C++, onde a perda de memória decorre do esquecimento explícito da liberação de ponteiros pelo programador, no ecossistema Python o problema assume uma forma mais sutil. Na runtime do Python 3.14.7, o vazamento ocorre quase sempre por retenção não intencional de referências viva no gráfico de objetos da aplicação, impedindo que o coletor de lixo limpe a estrutura.
Quando um processo consome centenas de megabytes além do previsto, agendar reinicializações periódicas no Kubernetes ou no systemd funciona apenas como um paliativo temporário perigoso. Para resolver o problema em sua raiz, é necessário entender a arquitetura do gerenciador de memória do CPython, isolar os gargalos de alocação com ferramentas especializadas de profilagem e reestruturar os padrões de código que impedem o descarte automático das estruturas de dados.
Por que a memória do processo Python continua crescendo em produção?
O interpretador CPython utiliza um sistema híbrido de gerenciamento de memória baseado primordialmente em contagem de referências (reference counting), complementado por um coletor de lixo cíclico (cyclic garbage collector). Cada objeto no Python possui um cabeçalho PyObject que armazena seu tipo e o número atual de referências apontadas para ele. Assim que essa contagem cai a zero, o CPython desaloca a memória do objeto imediatamente.
O problema surge quando referências indesejadas continuam ativas em escopos de vida longa. Se um objeto é inserido em uma lista global, em um dicionário de módulo, em um atributo de classe ou capturado dentro de uma closure de função de vida longa, seu contador de referências jamais atingirá zero. Consequentemente, o interpretador entende que aquele bloco de dados ainda é útil e recusa-se a descartá-lo.
Além disso, o alocador interno do CPython, chamado pymalloc, gerencia blocos pequenos de memória divididos em arenas, pools e blocks. Quando o Python libera a memória de um objeto interno, essa memória frequentemente retorna para o pool interno do pymalloc e não diretamente para o sistema operacional. Esse comportamento gera fragmentação da memória física (Resident Set Size - RSS), fazendo com que o processo pareça reter RAM mesmo após a execução de operações pesadas.
Para agravar o cenário, bibliotecas escritas em extensões C, Rust ou C++ integradas ao Python podem alocar memória nativa via malloc diretamente no heap do sistema. O Garbage Collector do CPython é completamente cego a essas alocações nativas, tornando invisíveis os vazamentos provocados por bindings mal implementados ou manipuladores de arquivos e conexões que não fecham seus ponteiros de baixo nível.
Como identificar um vazamento de memória em python na prática?
Diagnosticar retenções de memória inspecionando o código a olho nu é uma tarefa ineficiente. Embora o módulo nativo tracemalloc ajude em cenários simples, ele adiciona um overhead considerável de execução e não consegue monitorar alocações nativas realizadas fora do interpretador CPython. A solução moderna e de altíssima precisão para essa análise é o Memray, um profiler de memória desenvolvido especificamente para aplicações Python.
O Memray é capaz de rastrear alocações tanto no nível do interpretador Python quanto nas extensões nativas em C. Ele registra cada instrução de alocação de memória com um impacto de desempenho mínimo, permitindo que você execute o profiler diretamente em ambientes de staging ou até em réplicas de produção controladas.
Para iniciar a análise, instale o Memray via gerenciador de pacotes e prepare o script que apresenta o sintoma de crescimento contínuo de consumo de RAM:
pip install memray
Considere a aplicação de exemplo abaixo, que simula um vazamento clássico decorrente do acúmulo de histórico de requisições em uma lista mantida em memória global sem descarte:
import time

# Simulação de um registro global de auditoria sem limite de tamanho
HISTORICO_REQUISICOES = []

class PayloadProcessado:
    def __init__(self, identificador: int, dados: bytes):
        self.identificador = identificador
        self.dados = dados

def processar_requisicao(indice: int) -> None:
    # Cria um buffer substancial de 1 MB para cada chamada
    conteudo = bytes(1024 * 1024)
    payload = PayloadProcessado(identificador=indice, dados=conteudo)

    # Erro de arquitetura: o objeto é retido globalmente para sempre
    HISTORICO_REQUISICOES.append(payload)

def executar_servico() -> None:
    for i in range(100):
        processar_requisicao(i)
        time.sleep(0.01)

if __name__ == "__main__":
    executar_servico()
Gravando o perfil de alocação com o Memray CLI
Para capturar o perfil completo de alocação do script sem alterar uma única linha do código-fonte, execute o comando memray run no seu terminal. O parâmetro --native deve ser adicionado sempre que você suspeitar de vazamentos em bibliotecas C nativas como NumPy, Pandas ou drivers de banco de dados:
python -m memray run --native -o perfil_memoria.bin meu_script.py
Ao finalizar a execução, o Memray gera um arquivo binário contendo a árvore completa de alocações e liberações de memória ao longo do tempo. O próximo passo é converter esses dados brutos em uma visualização inteligível.
Analisando o Flamegraph para encontrar a linha exata
O formato mais eficiente para interpretar os dados do Memray é o gráfico de chama (flamegraph). Execute o comando de geração de relatório HTML a partir do arquivo binário gerado:
python -m memray flamegraph perfil_memoria.bin -o relatorio.html
Abra o arquivo relatorio.html em qualquer navegador web. A interface interativa exibirá barras horizontais onde a largura de cada bloco representa a quantidade total de memória alocada por uma determinada função. Ao inspecionar o topo da pilha de chamas, você identificará a linha exata do código onde a memória foi alocada e retida, permitindo rastrear o caminho percorrido pelo dado no código até o ponto de estagnação.
Quais são os padrões de código que mais causam retenção involuntária?
Analisar relatórios de profilers revela que a grande maioria dos vazamentos em Python decorre de três padrões de implementação recorrentes. Conhecer a mecânica interna desses erros previne que eles sejam introduzidos na base de código durante a fase de desenvolvimento.
| Padrão de Erro | Mecanismo do Vazamento | Impacto em Produção |
|---|---|---|
| Cache sem expiração | Objetos armazenados em dicionários globais sem limitação de tamanho (LRU) | Crescimento linear e infinito do RSS até o crash |
Referências circulares com __del__ |
Objetos cruzados impedem a contagem zero e sobrecarregam a limpeza cíclica | Acúmulo de objetos obsoletos na memória heap |
| Listeners e Callbacks | Eventos registram referências fortes a métodos de instâncias que deveriam ser descartadas | Previne a liberação de árvores inteiras de objetos |
O primeiro padrão é o uso incorreto de decoradores de armazenamento em cache. O decorador @functools.lru_cache quando aplicado sem o argumento maxsize (ou configurado como maxsize=None) armazena indefinidamente o resultado de cada chamada com parâmetros únicos. Se a sua aplicação recebe requisições de usuários com parâmetros altamente dinâmicos (como UUIDs ou timestamps), o cache crescerá indefinidamente até esgotar a RAM da máquina host.
O segundo padrão é o surgimento de referências circulares em estruturas de dados complexas. Ocorre quando o objeto A mantém uma referência para o objeto B, e o objeto B guarda uma referência de volta para o objeto A. O algoritmo de contagem de referências do Python falha nesses casos porque a contagem de ambos nunca chega a zero por conta própria. Embora o Garbage Collector cíclico do CPython seja projetado para identificar e quebrar esses ciclos, a presença do método finalizador __del__ ou dependências de módulos C pode impedir a liberação automática pelo coletor.
O terceiro padrão envolve a retenção por registradores de eventos ou manipuladores de sinal (signal handlers). Quando uma instância de classe registra um de seus métodos como callback em um barramento de eventos de vida longa ou em uma biblioteca gráfica, o barramento passa a manter uma referência forte para a instância inteira. Mesmo que o restante da aplicação perca a referência desse objeto, o manipulador de eventos impedirá que a memória seja limpa.
Como corrigir cada padrão de vazamento e validar a solução?
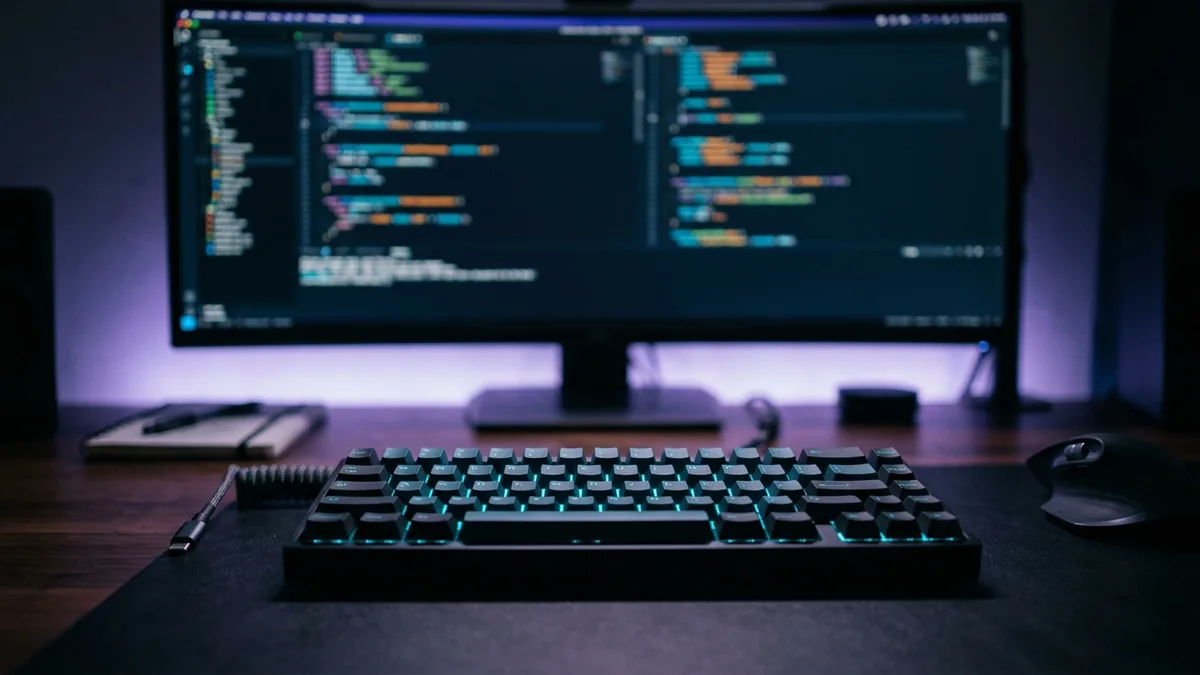
Para erradicar a retenção Indesejada de memória, precisamos adotar técnicas de refatoração focadas em controle de escopo e uso de referências fracas. A primeira regra de ouro é substituir caches ilimitados por estruturas com política de descarte definida ou tabelas de referência fraca através do módulo nativo weakref.
Se a intenção do seu código é manter instâncias armazenadas em cache apenas enquanto elas estiverem em uso por outras partes da aplicação, utilize um weakref.WeakValueDictionary. Essa estrutura de dados não incrementa o contador de referências forte do objeto, permitindo que o Garbage Collector limpe a instância assim que ela sair do escopo principal:
import weakref
import gc

class ObjetoPesado:
    def __init__(self, chave: str):
        self.chave = chave
        self.dados = bytearray(10 * 1024 * 1024)  # 10 MB

class GerenciadorCacheRefatorado:
    def __init__(self):
        # WeakValueDictionary não impede a desalocação pelo Garbage Collector
        self._cache: weakref.WeakValueDictionary[str, ObjetoPesado] = weakref.WeakValueDictionary()

    def obter_objeto(self, chave: str) -> ObjetoPesado:
        obj = self._cache.get(chave)
        if obj is None:
            obj = ObjetoPesado(chave)
            self._cache[chave] = obj
        return obj

def testar_comportamento_memoria():
    cache = GerenciadorCacheRefatorado()

    # Criação dentro de um escopo temporário
    def escopo_temporario():
        item = cache.obter_objeto("sessao_123")
        print(f"Objeto em uso dentro do escopo. Itens no cache: {len(cache._cache)}")

    escopo_temporario()

    # Força a coleta de lixo cíclica para validar a liberação imediata
    gc.collect()

    print(f"Após sair do escopo local. Itens restantes no cache: {len(cache._cache)}")

if __name__ == "__main__":
    testar_comportamento_memoria()
Outra refatoração essencial envolve a substituição do carregamento integral de coleções por processamento contínuo via geradores (generators) ou iteradores. Em vez de ler um arquivo extenso ou uma consulta massiva do PostgreSQL 18.6 para uma lista em memória, estruture o pipeline para consumir registros em lotes utilizando a instrução yield:
from typing import Iterator

def ler_registros_grandes(caminho_arquivo: str) -> Iterator[str]:
    """Processa arquivos gigabytes linha por linha sem inflar o RSS do processo."""
    with open(caminho_arquivo, mode="r", encoding="utf-8") as arquivo:
        for linha in arquivo:
            # Processa e cede o dado individualmente sem carregar tudo na RAM
            yield linha.strip()

def processar_pipeline(caminho: str) -> None:
    for registro in ler_registros_grandes(caminho):
        # Operação direta sobre o dado individual
        pass
Por fim, para validar que a correção surtiu efeito, execute o Memray utilizando a opção de comparação de relatórios (diff). Grave a execução da versão antiga do seu serviço e da nova versão refatorada para gerar uma comparação direta:
python -m memray run -o perfil_antigo.bin versao_antiga.py
python -m memray run -o perfil_novo.bin versao_nova.py
python -m memray stats perfil_novo.bin
O comando stats exibirá o número total de alocações realizadas, o pico de consumo de memória (peak memory usage) e o tamanho total alocado. A comparação garantirá que o gráfico de consumo de RAM atinja um platô estável em vez de apresentar uma rampa ascendente ao longo do tempo de operação.
Conclusão
Dominar a análise e a eliminação de gargalos no gerenciamento de memória é um requisito indispensável para manter aplicações Python escaláveis e resilientes em produção. Ao entender como a contagem de referências e a alocação nativa interagem com o sistema operacional, você deixa de depender de reinicializações paliativas de containers para adotar uma abordagem verdadeiramente diagnóstica.
Ferramentas modernas como o Memray transformam o processo de profilagem em uma tarefa determinística, revelando instantaneamente a linha do código responsável pela retenção de dados. Integrar esses testes de profilagem à sua esteira de integração contínua é o caminho definitivo para erradicar qualquer vazamento de memória em python do seu ambiente de produção.