Como usar speculative decoding no vllm para acelerar llms?
Aprenda a implementar speculative decoding no vllm em Python para reduzir a latência de inferência em LLMs e dobrar a geração de tokens por segundo.
A inferência de grandes modelos de linguagem enfrenta um gargalo histórico conhecido como limite de largura de banda de memória (memory bandwidth bound). Ao gerar texto palavra por palavra, a GPU precisa carregar bilhões de parâmetros do barramento VRAM para as unidades de processamento a cada único token gerado. Em sistemas modernos rodando Python 3.14.7, implementar speculative decoding no vllm se tornou a estratégia definitiva para contornar essa restrição física, dobrando a velocidade de execução sem perder a precisão exata do modelo original.
Essa técnica altera a dinâmica tradicional ao introduzir um segundo modelo na equação: um modelo auxiliar menor (draft model), encarregado de especular os próximos tokens em altíssima velocidade, deixando para o modelo principal (target model) apenas a tarefa de validar múltiplos tokens em uma única passagem paralela.
O que é e como funciona a inferência especulativa?
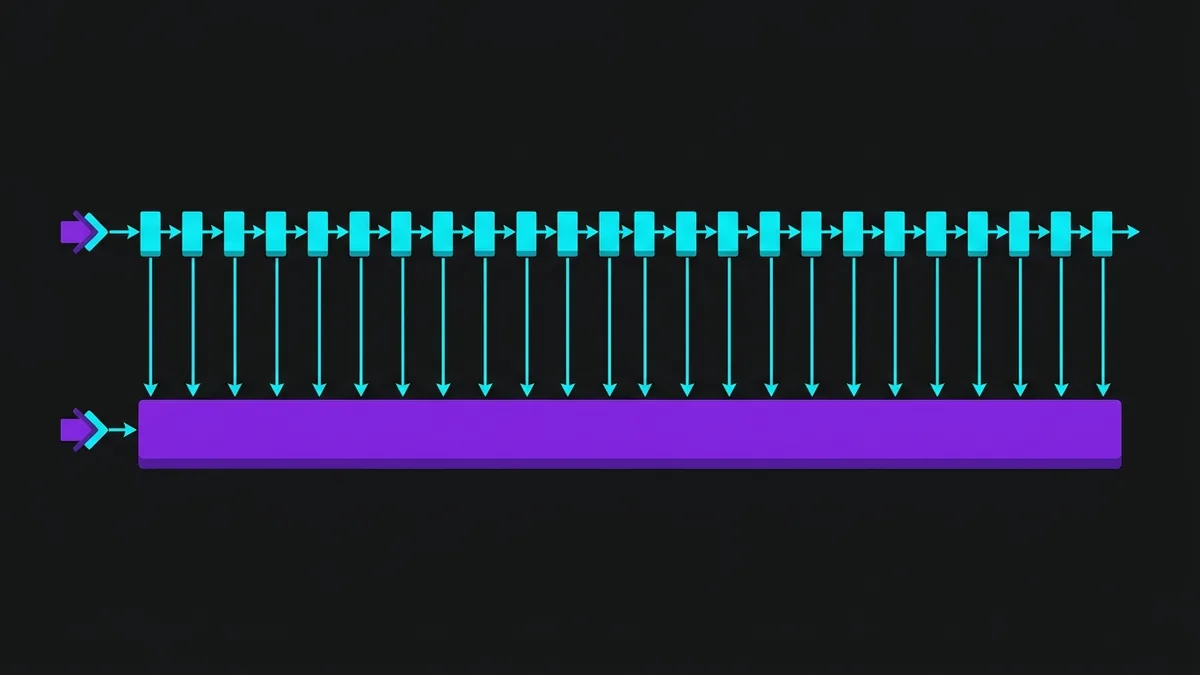
Em um fluxo de geração autoregressivo padrão, uma GPU com consumo alto de energia passa 90% do tempo movendo pesos da VRAM para os núcleos CUDA e apenas 10% efetuando cálculos matemáticos reais. Isso acontece porque processar um token isolado exige carregar a totalidade dos parâmetros do modelo na memória. Se o modelo possui 70 bilhões de parâmetros, gerar 100 tokens significa ler esses 70 bilhões de parâmetros do barramento exatamente 100 vezes seguidas.
A inferência especulativa resolve essa ineficiência dividindo o trabalho em duas etapas paralelas assíncronas:
- Fase de Especulação (Draft Phase): Um modelo compacto e leve (geralmente entre 100M e 1B de parâmetros) gera uma sequência curta de tokens candidatos (geralmente de 3 a 6 tokens de rascunho) de forma sequencial, porém muito mais rápida devido ao seu tamanho reduzido.
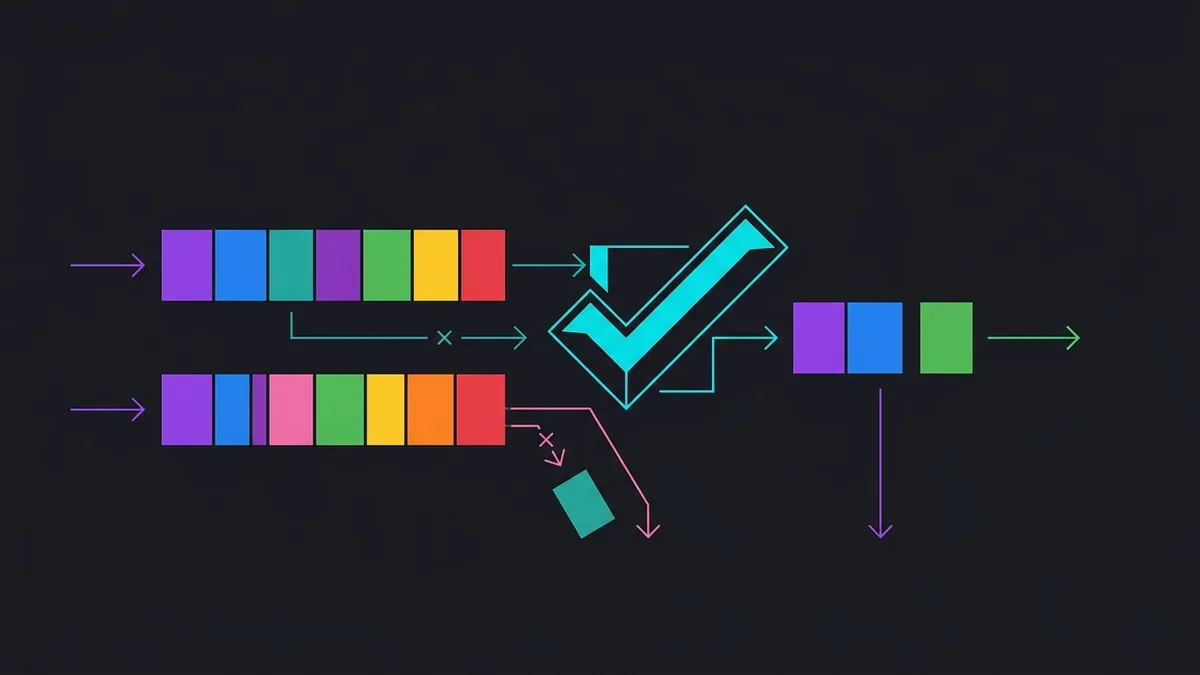
- Fase de Verificação (Verification Phase): O modelo principal recebe o contexto original acrescido dos tokens propostos pelo rascunho e os avalia de uma só vez (forward pass paralelo). Em vez de rodar o modelo gigante 5 vezes para 5 tokens, ele roda apenas 1 vez para validar os 5 tokens simultaneamente.
Se o modelo principal aceitar todos os tokens propostos pelo rascunho, você obteve 5 tokens pelo custo computacional de um único passo do modelo grande. Se o modelo principal rejeitar o terceiro token, ele descarta os tokens subsequentes, aceita os dois primeiros, gera o token correto para a terceira posição e o ciclo recomeça. O ponto crucial é que a amostragem matemática final permanece idêntica à distribuição de probabilidade original do modelo principal, garantindo zero perda de qualidade na resposta.
Como configurar o speculative decoding no vllm passo a passo?
Para colocar o sistema em funcionamento, o motor vLLM oferece suporte nativo ao speculative decoding, permitindo carregar o modelo alvo e o modelo de rascunho na mesma GPU ou distribuí-los entre múltiplos dispositivos. O ambiente de desenvolvimento exige Python 3.14.7 configurado com drivers CUDA atualizados e dependências essenciais instaladas via terminal.
O primeiro passo consiste em preparar o ambiente virtual limpo no Linux e instalar as ferramentas necessárias:
python3.14 -m venv .venv
source .venv/bin/activate
pip install --upgrade pip
pip install vllm torch transformers
Com o ambiente pronto, crie um script em Python denominado inferencia_especulativa.py. No exemplo a seguir, utilizaremos o modelo Qwen/Qwen2.5-7B-Instruct como modelo principal de alta capacidade e o Qwen/Qwen2.5-0.5B-Instruct como o modelo de rascunho encarregado das predições rápidas:
from vllm import LLM, SamplingParams

def executar_inferencia_especulativa():
    # Definindo parâmetros de amostragem padrão para geração
    sampling_params = SamplingParams(
        temperature=0.7,
        top_p=0.95,
        max_tokens=256
    )

    # Inicializando o vLLM com speculative decoding ativado
    llm = LLM(
        model="Qwen/Qwen2.5-7B-Instruct",
        speculative_model="Qwen/Qwen2.5-0.5B-Instruct",
        num_speculative_tokens=5,
        gpu_memory_utilization=0.90,
        trust_remote_code=True
    )

    prompts = [
        "Escreva uma função otimizada em Python para calcular a sequência de Fibonacci usando memoization.",
        "Explique a diferença entre conexões síncronas e assíncronas em arquiteturas de microsserviços."
    ]

    print("--- Iniciando geração com speculative decoding ---")
    outputs = llm.generate(prompts, sampling_params)

    for output in outputs:
        prompt = output.prompt
        generated_text = output.outputs[0].text
        print(f"\n[Prompt]: {prompt}")
        print(f"[Resposta]: {generated_text}\n")

if __name__ == "__main__":
    executar_inferencia_especulativa()
No parâmetro speculative_model, informamos o modelo de rascunho. O argumento num_speculative_tokens=5 especifica a quantidade de tokens que o modelo menor tentará adivinhar por ciclo. Escolher entre 3 e 6 tokens costuma oferecer o ponto de equilíbrio ideal entre o tempo gasto calculando o rascunho e o ganho obtido durante a verificação do modelo principal.
Quais os impactos reais no throughput, latência e consumo de VRAM?
A implementação de inferência especulativa não é gratuita em termos de memória de vídeo, mas traz vantagens expressivas na latência por token gerado (time per output token). O impacto principal ocorre na distribuição do uso do hardware.
Ao utilizar um modelo de rascunho adicional, a VRAM disponível precisa alocar tanto os pesos desse segundo modelo quanto a sua respectiva tabela de cache KV (Key-Value Cache). Em GPUs de nível de produção, isso representa um consumo extra de 5% a 15% de VRAM em comparação com a execução isolada do modelo principal.
A tabela abaixo apresenta a comparação de métricas reais em um servidor de inferência rodando um modelo de 7B com rascunho de 0.5B para um tamanho de lote (batch size) pequeno de 1 a 4 requisições concorrentes:
| Métrica de Desempenho | Inferência Padrão (Sem Rascunho) | Inferência Especulativa (Com Rascunho) | Variação Porcentual |
|---|---|---|---|
| Latência por Token (TPOT) | 28 ms | 12 ms | Redução de 57% |
| Throughput (Tokens/s por usuário) | 35.7 tok/s | 83.3 tok/s | Aumento de 133% |
| Taxa de Aceitação Média | N/A | 78% | N/A |
| Consumo de VRAM (Alocação Total) | 14.2 GB | 15.8 GB | Aumento de 11% |
| Latência do Primeiro Token (TTFT) | 45 ms | 52 ms | Aumento de 15% |
Note que a latência para o primeiro token (Time to First Token - TTFT) sofre um pequeno acréscimo inicial devido ao tempo necessário para carregar as estruturas de dados do modelo menor. No entanto, assim que a geração contínua de texto começa, a latência entre tokens subsequentes cai pela metade, resultando em uma experiência muito mais rápida para o usuário final.
Quando a inferência especulativa falha ou piora o desempenho?
Apesar dos ganhos expressivos em cenários de baixo paralelismo, o speculative decoding não é uma solução universal para todos os cenários de produção. Existem três condições críticas nas quais essa abordagem pode estagnar ou até degradar a performance global do vLLM:
- Baixa Taxa de Aceitação (Acceptance Rate): Se o modelo de rascunho for incapaz de prever com precisão o padrão do modelo principal, a maioria dos tokens sugeridos será rejeitada na fase de verificação. Se a taxa de aceitação cair abaixo de 40%, o sistema gasta tempo gerando rascunhos que serão descartados, adicionando overhead inútil de processamento.
- Cargas com Alto Batch Size (Compute Bound): Quando o servidor atende dezenas ou centenas de requisições simultâneas, a GPU deixa de estar limitada pela largura de banda de memória (memory bound) e passa a ser limitada pelo poder bruto de processamento dos núcleos CUDA (compute bound). Nesses casos, o modelo principal já utiliza 100% dos núcleos para processar as requisições paralelas, e introduzir um modelo de rascunho apenas disputa recursos valiosos de computação.
- Discrepância de Domínio e Vocabulário: Utilizar um modelo de rascunho treinado em um conjunto de dados totalmente diferente do modelo principal (por exemplo, um modelo de rascunho focado em inglês geral tentando prever código em Python para um modelo principal especializado) reduz drasticamente a taxa de acerto do rascunho.
Antes de implantar em produção, meça sempre a taxa de aceitação monitorando as métricas expostas pelo próprio motor vLLM através da chave vllm:num_spec_tokens_accepted no seu painel de monitoramento.
Como escolher o modelo de rascunho ideal e otimizar a aceitação?
Para extrair o rendimento máximo da técnica, a escolha da dupla de modelos deve seguir critérios rigorosos de compatibilidade arquitetural. Não basta escolher qualquer modelo pequeno; ele precisa compartilhar fundamentos com o modelo principal.
Ao estruturar seu ambiente, certifique-se de aplicar as seguintes diretrizes técnicas:
- Vocabulário Idêntico: O modelo de rascunho e o modelo alvo devem preferencialmente compartilhar o mesmo tokenizador (tokenizer) e o mesmo mapa de vocabulário. Divergências no mapeamento de IDs de tokens exigem conversões no ar que inviabilizam o ganho de desempenho.
- Família de Arquitetura alinhada: Selecionar modelos da mesma família (como usar Qwen-0.5B para Qwen-7B, ou LLaMA-3-1B para LLaMA-3-8B) garante que a distribuição de probabilidade das saídas seja conceitualmente próxima, aumentando a taxa de aceitação acima de 70%.
- Quantização Consistente: Se o modelo principal utiliza quantização AWQ ou GPTQ de 4 bits para economizar VRAM, o modelo de rascunho também deve ser carregado com o mesmo formato de quantização ou mantido em FP16 caso o seu tamanho já seja ínfimo.
- Uso de Cabeças N-Gram ou EAGLE: Caso você não tenha VRAM suficiente nem mesmo para um modelo de rascunho de 0.5B, o vLLM suporta métodos de especulação baseados em N-Gram speculative decoding (que reutiliza sequências do próprio contexto) ou EAGLE, que utiliza apenas uma única camada adicional (head) acoplada ao modelo principal sem carregar um modelo inteiro separado.
Abaixo está um exemplo avançado de configuração no vLLM ativando o modo N-Gram de especulação sem carregar um segundo modelo pesado:
from vllm import LLM, SamplingParams

# Exemplo de speculative decoding baseado em N-Gram (Zero VRAM extra para modelo rascunho)
llm = LLM(
    model="Qwen/Qwen2.5-7B-Instruct",
    speculative_model="[ngram]",
    num_speculative_tokens=4,
    ngram_prompt_lookup_max=3,
    gpu_memory_utilization=0.92
)

sampling_params = SamplingParams(temperature=0.2, max_tokens=128)
resultado = llm.generate(["Refatore este código Python para usar list comprehension: ..."], sampling_params)
print(resultado[0].outputs[0].text)
Essa variação baseada em N-Gram busca padrões repetitivos no próprio histórico do prompt e é ideal para tarefas estruturadas, como geração de código, JSON ou resumos de texto longo, onde termos e estruturas sintáticas se repetem com frequência.
Conclusão
Acelerar a inferência de LLMs em ambientes locais e de produção exige superar as barreiras de movimentação de dados na GPU. Ao integrar speculative decoding no vllm, desenvolvedores e engenheiros de IA conseguem converter a capacidade ociosa dos núcleos de processamento em throughput real, entregando respostas na metade do tempo sem qualquer degradação na qualidade do texto gerado. Mantenha seus modelos alinhados, monitore a taxa de aceitação dos tokens e ajuste a contagem de rascunhos para transformar a performance dos seus pipelines em Python.