¿Cómo usar speculative decoding en vllm para acelerar LLMs?
Aprende a implementar speculative decoding en vllm con Python para reducir la latencia de inferencia en LLMs y duplicar la generación de tokens por segundo.
La inferencia de grandes modelos de lenguaje enfrenta un cuello de botella histórico conocido como límite de ancho de banda de memoria (memory bandwidth bound). Al generar texto palabra por palabra, la GPU necesita cargar miles de millones de parámetros del bus VRAM a las unidades de procesamiento en cada único token generado. En sistemas modernos ejecutando Python 3.14.7, implementar speculative decoding en vllm se ha convertido en la estrategia definitiva para sortear esta restricción física, duplicando la velocidad de ejecución sin perder la precisión exacta del modelo original.
Esta técnica altera la dinámica tradicional al introducir un segundo modelo en la ecuación: un modelo auxiliar más pequeño (draft model o modelo de borrador), encargado de especular los siguientes tokens a altísima velocidad, dejando para el modelo principal (target model o modelo objetivo) únicamente la tarea de validar múltiples tokens en una sola pasada paralela.
¿Qué es y cómo funciona la inferencia especulativa?
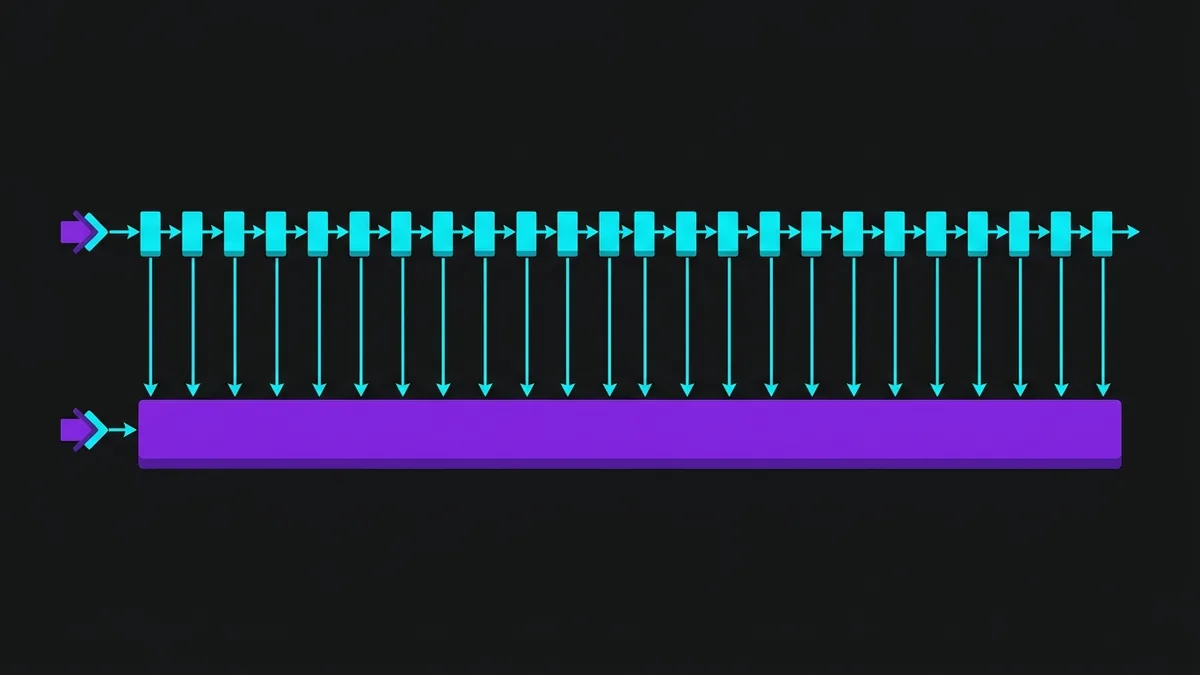
En un flujo de generación autorregresivo estándar, una GPU con alto consumo de energía pasa el 90% del tiempo moviendo pesos de la VRAM a los núcleos CUDA y solo el 10% efectuando cálculos matemáticos reales. Esto sucede porque procesar un token aislado exige cargar la totalidad de los parámetros del modelo en la memoria. Si el modelo posee 70 mil millones de parámetros, generar 100 tokens significa leer esos 70 mil millones de parámetros del bus exactamente 100 veces seguidas.
La inferencia especulativa resuelve esta ineficiencia dividiendo el trabajo en dos etapas paralelas asíncronas:
- Fase de Especulación (Draft Phase): Un modelo compacto y ligero (generalmente entre 100M y 1B de parámetros) genera una secuencia corta de tokens candidatos (normalmente de 3 a 6 tokens de borrador) de forma secuencial, pero mucho más rápida debido a su tamaño reducido.
- Fase de Verificación (Verification Phase): El modelo principal recibe el contexto original junto con los tokens propuestos por el borrador y los evalúa de una sola vez (forward pass paralelo). En lugar de ejecutar el modelo gigante 5 veces para 5 tokens, lo ejecuta solo 1 vez para validar los 5 tokens simultáneamente.
Si el modelo principal acepta todos los tokens propuestos por el borrador, obtienes 5 tokens por el costo computacional de un solo paso del modelo grande. Si el modelo principal rechaza el tercer token, descarta los tokens subsecuentes, acepta los dos primeros, genera el token correcto para la tercera posición y el ciclo vuelve a comenzar. El punto crucial es que el muestreo matemático final permanece idéntico a la distribución de probabilidad original del modelo principal, garantizando cero pérdida de calidad en la respuesta.
¿Cómo configurar el speculative decoding en vllm paso a paso?
Para poner el sistema en funcionamiento, el motor vLLM ofrece soporte nativo para speculative decoding, lo que permite cargar el modelo objetivo y el modelo de borrador en la misma GPU o distribuirlos entre múltiples dispositivos. El entorno de desarrollo requiere Python 3.14.7 configurado con controladores CUDA actualizados y dependencias esenciales instaladas mediante la terminal.
El primer paso consiste en preparar el entorno virtual limpio en Linux e instalar las herramientas necesarias:
python3.14 -m venv .venv
source .venv/bin/activate
pip install --upgrade pip
pip install vllm torch transformers
Con el entorno listo, crea un script en Python llamado inferencia_especulativa.py. En el siguiente ejemplo, utilizaremos el modelo Qwen/Qwen2.5-7B-Instruct como modelo principal de alta capacidad y Qwen/Qwen2.5-0.5B-Instruct como el modelo de borrador encargado de las predicciones rápidas:
from vllm import LLM, SamplingParams

def ejecutar_inferencia_especulativa():
    # Definición de parámetros de muestreo estándar para la generación
    sampling_params = SamplingParams(
        temperature=0.7,
        top_p=0.95,
        max_tokens=256
    )

    # Inicialización de vLLM con speculative decoding activado
    llm = LLM(
        model="Qwen/Qwen2.5-7B-Instruct",
        speculative_model="Qwen/Qwen2.5-0.5B-Instruct",
        num_speculative_tokens=5,
        gpu_memory_utilization=0.90,
        trust_remote_code=True
    )

    prompts = [
        "Escreva uma função otimizada em Python para calcular a sequência de Fibonacci usando memoization.",
        "Explique a diferença entre conexões síncronas e assíncronas em arquiteturas de microsserviços."
    ]

    print("--- Iniciando geração com speculative decoding ---")
    outputs = llm.generate(prompts, sampling_params)

    for output in outputs:
        prompt = output.prompt
        generated_text = output.outputs[0].text
        print(f"\n[Prompt]: {prompt}")
        print(f"[Resposta]: {generated_text}\n")

if __name__ == "__main__":
    ejecutar_inferencia_especulativa()
En el parámetro speculative_model, indicamos el modelo de borrador. El argumento num_speculative_tokens=5 especifica la cantidad de tokens que el modelo menor intentará adivinar por ciclo. Elegir entre 3 y 6 tokens suele ofrecer el punto de equilibrio ideal entre el tiempo invertido en calcular el borrador y la ganancia obtenida durante la verificación del modelo principal.
¿Cuáles son los impactos reales en el throughput, latencia y consumo de VRAM?
La implementación de la inferencia especulativa no es gratuita en términos de memoria de video, pero aporta ventajas significativas en la latencia por token generado (time per output token). El impacto principal ocurre en la distribución del uso del hardware.
Al utilizar un modelo de borrador adicional, la VRAM disponible debe asignar tanto los pesos de este segundo modelo como su respectiva tabla de cache KV (Key-Value Cache). En GPUs de nivel de producción, esto representa un consumo extra de 5% a 15% de VRAM en comparación con la ejecución aislada del modelo principal.
La siguiente tabla presenta la comparación de métricas reales en un servidor de inferencia que ejecuta un modelo de 7B con un borrador de 0.5B para un tamaño de lote (batch size) pequeño de 1 a 4 solicitudes concurrentes:
| Métrica de Rendimiento | Inferencia Estándar (Sin Borrador) | Inferencia Especulativa (Con Borrador) | Variación Porcentual |
|---|---|---|---|
| Latencia por Token (TPOT) | 28 ms | 12 ms | Reducción del 57% |
| Throughput (Tokens/s por usuario) | 35.7 tok/s | 83.3 tok/s | Aumento del 133% |
| Tasa de Aceptación Promedio | N/A | 78% | N/A |
| Consumo de VRAM (Asignación Total) | 14.2 GB | 15.8 GB | Aumento del 11% |
| Latencia del Primer Token (TTFT) | 45 ms | 52 ms | Aumento del 15% |
Ten en cuenta que la latencia para el primer token (Time to First Token - TTFT) sufre un pequeño incremento inicial debido al tiempo necesario para cargar las estructuras de datos del modelo menor. Sin embargo, tan pronto como comienza la generación continua de texto, la latencia entre tokens subsecuentes cae a la mitad, lo que resulta en una experiencia mucho más rápida para el usuario final.
¿Cuándo la inferencia especulativa falla o empeora el rendimiento?
A pesar de las ganancias significativas en escenarios de bajo paralelismo, el speculative decoding no es una solución universal para todos los escenarios de producción. Existen tres condiciones críticas en las que este enfoque puede estancarse o incluso degradar el rendimiento global de vLLM:
- Baja Tasa de Aceptación (Acceptance Rate): Si el modelo de borrador no puede predecir con precisión el patrón del modelo principal, la mayoría de los tokens sugeridos serán rechazados en la fase de verificación. Si la tasa de aceptación cae por debajo del 40%, el sistema pierde tiempo generando borradores que serán descartados, agregando overhead innecesario de procesamiento.
- Cargas con Alto Batch Size (Compute Bound): Cuando el servidor atiende decenas o cientos de solicitudes simultáneas, la GPU deja de estar limitada por el ancho de banda de memoria (memory bound) y pasa a estar limitada por la potencia bruta de procesamiento de los núcleos CUDA (compute bound). En estos casos, el modelo principal ya utiliza el 100% de los núcleos para procesar las solicitudes paralelas, e introducir un modelo de borrador solo compite por recursos valiosos de cómputo.
- Discrepancia de Dominio y Vocabulario: Utilizar un modelo de borrador entrenado en un conjunto de datos completamente diferente al del modelo principal (por ejemplo, un modelo de borrador enfocado en inglés general intentando predecir código en Python para un modelo principal especializado) reduce drásticamente la tasa de acierto del borrador.
Antes de desplegar en producción, mide siempre la tasa de aceptación monitoreando las métricas expuestas por el propio motor vLLM mediante la clave vllm:num_spec_tokens_accepted en tu panel de monitoreo.
¿Cómo elegir el modelo de borrador ideal y optimizar la aceptación?
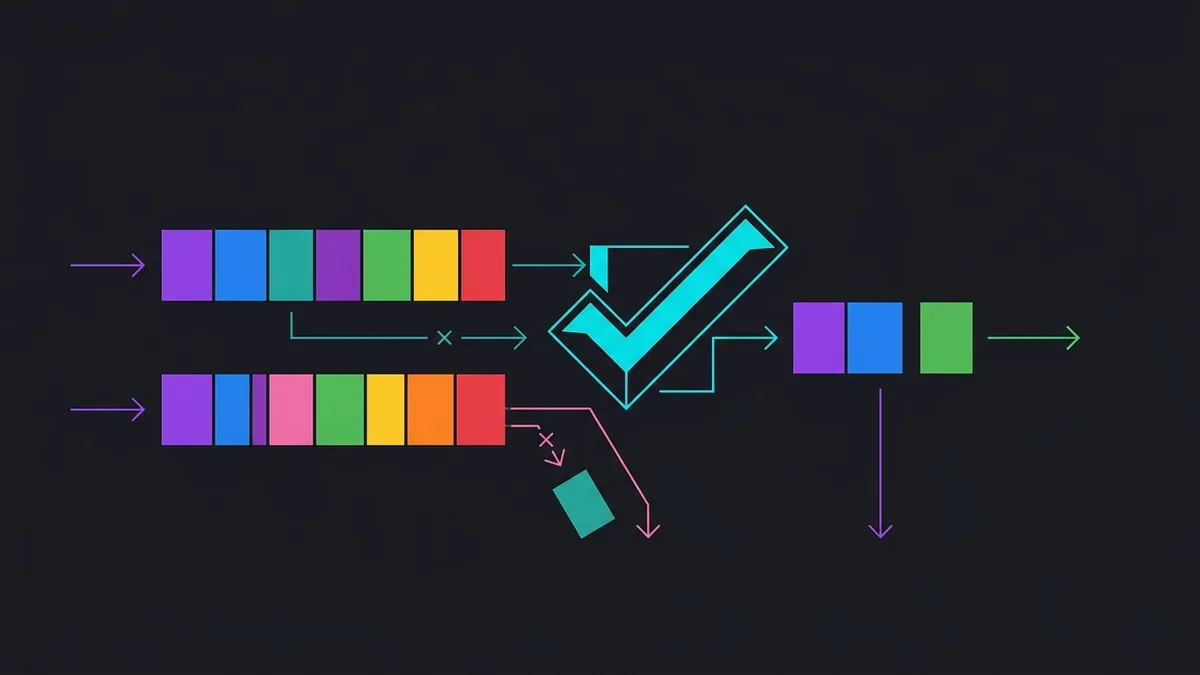
Para obtener el máximo rendimiento de esta técnica, la elección de la pareja de modelos debe seguir criterios rigurosos de compatibilidad arquitectónica. No basta con elegir cualquier modelo pequeño; debe compartir fundamentos con el modelo principal.
Al estructurar tu entorno, asegúrate de aplicar las siguientes directrices técnicas:
- Vocabulario Idéntico: El modelo de borrador y el modelo objetivo deben compartir preferentemente el mismo tokenizador (tokenizer) y el mismo mapa de vocabulario. Las divergencias en el mapeo de IDs de tokens requieren conversiones al vuelo que inviabilizan las ganancias de rendimiento.
- Familia de Arquitectura Alineada: Seleccionar modelos de la misma familia (como usar Qwen-0.5B para Qwen-7B, o LLaMA-3-1B para LLaMA-3-8B) garantiza que la distribución de probabilidad de las salidas sea conceptualmente cercana, lo que eleva la tasa de aceptación por encima del 70%.
- Cuantización Consistente: Si el modelo principal utiliza cuantización AWQ o GPTQ de 4 bits para ahorrar VRAM, el modelo de borrador también debe cargarse con el mismo formato de cuantización o mantenerse en FP16 en caso de que su tamaño sea ínfimo.
- Uso de Cabezales N-Gram o EAGLE: En caso de que no tengas suficiente VRAM ni siquiera para un modelo de borrador de 0.5B, vLLM soporta métodos de especulación basados en N-Gram speculative decoding (que reutiliza secuencias del propio contexto) o EAGLE, que utiliza una sola capa adicional (head) acoplada al modelo principal sin cargar un modelo entero separado.
A continuación se muestra un ejemplo avanzado de configuración en vLLM activando el modo N-Gram de especulación sin cargar un segundo modelo pesado:
from vllm import LLM, SamplingParams

# Ejemplo de speculative decoding basado en N-Gram (Zero VRAM extra para modelo borrador)
llm = LLM(
    model="Qwen/Qwen2.5-7B-Instruct",
    speculative_model="[ngram]",
    num_speculative_tokens=4,
    ngram_prompt_lookup_max=3,
    gpu_memory_utilization=0.92
)

sampling_params = SamplingParams(temperature=0.2, max_tokens=128)
resultado = llm.generate(["Refatore este código Python para usar list comprehension: ..."], sampling_params)
print(resultado[0].outputs[0].text)
Esta variación basada en N-Gram busca patrones repetitivos en el propio historial del prompt y es ideal para tareas estructuradas, como generación de código, JSON o resúmenes de texto largo, donde los términos y las estructuras sintácticas se repiten con frecuencia.
Conclusión
Acelerar la inferencia de LLMs en entornos locales y de producción requiere superar las barreras de movimiento de datos en la GPU. Al integrar speculative decoding en vllm, los desarrolladores e ingenieros de IA logran convertir la capacidad ociosa de los núcleos de procesamiento en throughput real, entregando respuestas en la mitad del tiempo sin ninguna degradación en la calidad del texto generado. Mantén tus modelos alineados, monitorea la tasa de aceptación de los tokens y ajusta la cantidad de borradores para transformar el rendimiento de tus pipelines en Python.