¿Pydantic AI vs LangChain: cuál elegir en 2026?
¿Dudas entre pydantic ai vs langchain en 2026? Mira la comparación técnica sobre arquitectura, tipado y rendimiento en Python 3.14.7 para decidir.
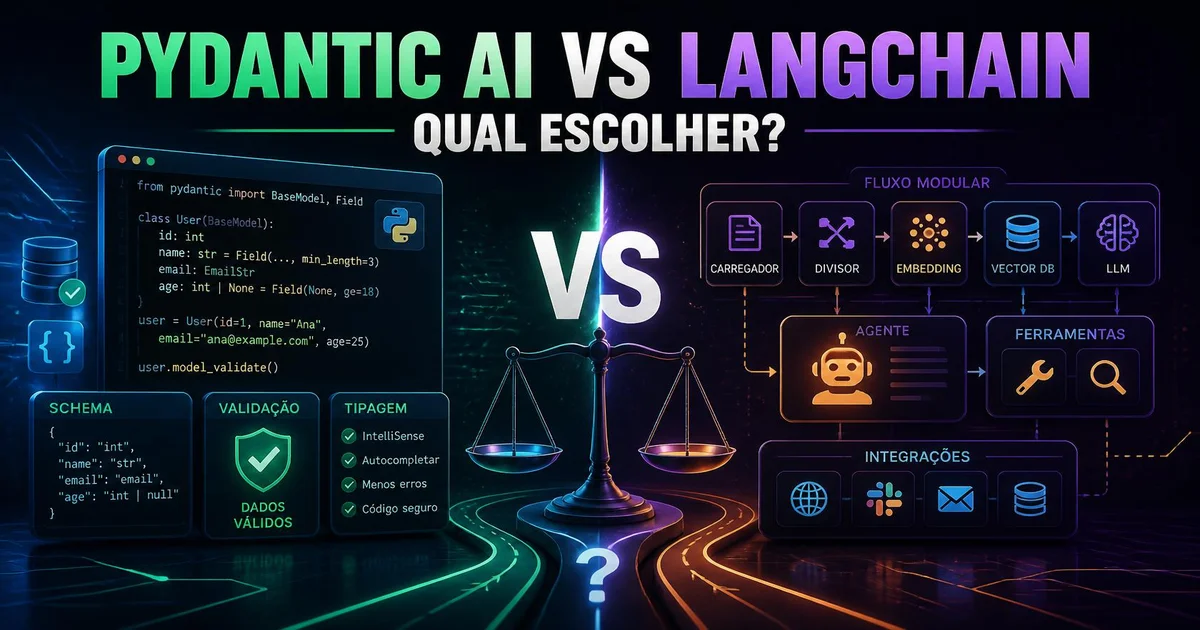
El ecosistema de desarrollo de software orientado a inteligencia artificial sufrió una transformación profunda en los últimos años. Si antes el estándar de la industria para orquestar llamadas a modelos de lenguaje residía en abstracciones de alto nivel llenas de capas ocultas, la búsqueda actual de previsibilidad y baja latencia cambió ese escenario. Al poner lado a lado pydantic ai vs langchain, la elección deja de ser una simple preferencia de sintaxis y se convierte en una decisión crítica de arquitectura de software, afectando la mantenibilidad del código, la facilidad de depuración y la integración con ecosistemas de producción modernizados en Python 3.14.7.
Históricamente, LangChain dominó las primeras fases de la ola de LLMs al proporcionar conectores para prácticamente cualquier base de datos vectorial o API del mercado. Sin embargo, el costo de esa conveniencia fue una sobrecarga considerable de abstracciones, cadenas rígidas y dificultades recurrentes en el rastreo de errores en tiempo de ejecución. En contrapartida, el surgimiento de Pydantic AI trajo al ecosistema de inteligencia artificial la misma filosofía que consagró a FastAPI: tipado estático riguroso, validación de datos nativa en el ciclo de ejecución y dependencia directa de Pydantic V2, permitiendo construir agentes con un control granular de flujo.
¿Qué cambió en el ecosistema de agentes de IA en Python?
En los comienzos de la integración de grandes modelos de lenguaje en aplicaciones corporativas, la principal barrera era la falta de estandarización en la comunicación entre el modelo y los sistemas externos. LangChain resolvió ese problema inicial encapsulando el envío de prompts, el procesamiento de respuestas y la ejecución de herramientas en conceptos como Chains y Agents. Sin embargo, a medida que los sistemas evolucionaron hacia microservicios críticos, los desarrolladores comenzaron a enfrentar severos cuellos de botella de mantenibilidad. Abstracciones demasiado profundas volvían el rastreo de llamadas una tarea compleja, donde una falla de validación en el retorno de un JSON resultaba en excepciones genéricas difíciles de depurar.
Con la madurez de las especificaciones de Function Calling y la consolidación del ecosistema moderno en Python 3.14.7, el enfoque del desarrollo migró de la facilidad de prototipado a la confiabilidad de ingeniería. La validación de esquema dejó de ser una etapa posterior a la llamada de la API del modelo para convertirse en la columna vertebral de la aplicación. Pydantic AI surgió exactamente en esa intersección: en lugar de intentar envolver toda la infraestructura en abstracciones propias, utiliza la validación estructurada de Pydantic para garantizar que cada entrada, salida y llamada a herramientas cumpla con contratos de tipo estrictos compilados en código nativo.
Este cambio conceptual refleja una tendencia clara en el ecosistema de innovación: los desarrolladores sénior prefieren herramientas explícitas, que se integran sin fricción al sistema de tipos del lenguaje y a las herramientas habituales de análisis estático como Mypy y Pyright, en lugar de frameworks monolíticos que imponen sus propias estructuras de datos internas.
¿Cómo comparar pydantic ai vs langchain en términos de arquitectura?
La diferencia fundamental entre ambas opciones radica en la filosofía de diseño y en el nivel de control expuesto al desarrollador. LangChain adopta un enfoque inclusivo y abarcador, intentando cubrir todos los escenarios posibles mediante módulos especializados como LangChain Core, LangGraph y LangSmith. Esta estructura en capas permite construir grafos complejos de estado, pero exige el aprendizaje de una vasta API propia y el manejo de objetos internos como HumanMessage, AIMessage y PromptTemplate.
Por otro lado, Pydantic AI fue diseñado desde cero con base en inyección de dependencias y tipado nativo de Python. En lugar de exigir estructuras exclusivas de mensajes y conectores, trata al agente como un objeto Python convencional configurado mediante modelos Pydantic. Los tipos genéricos de Python determinan la salida esperada del modelo, y el propio framework se encarga de reintentar llamadas automáticamente si la respuesta de la LLM viola el esquema estipulado. La validación ocurre en tiempo real durante la generación o parseo, aprovechando la velocidad del núcleo escrito en Rust por Pydantic V2.
La siguiente tabla sintetiza los principales criterios técnicos involucrados en la evaluación de pydantic ai vs langchain para escenarios corporativos:
| Criterio Técnico | LangChain | Pydantic AI |
|---|---|---|
| Filosofía de Diseño | Framework abarcador basado en grafos y cadenas | Biblioteca liviana orientada a tipos y validación estricta |
| Validación de Esquema | Capa adaptadora acoplada a los parsers del framework | Integración nativa de primera clase vía Pydantic V2 |
| Inyección de Dependencias | Paso manual de estado o vía contexto de grafo | Inyección nativa fuertemente tipada en el manejador del agente |
| Curva de Aprendizaje | Alta, debido al gran volumen de abstracciones propias | Baja para quien ya domina Python idiomático y FastAPI |
| Facilidad de Depuración | Compleja en cadenas profundas sin soporte de LangSmith | Simple, con stack traces directos del lenguaje Python |
| Rendimiento de Importación | Carga de muchos módulos y dependencias cruzadas | Inicialización liviana y rápida con baja sobrecarga |
Mientras que LangChain sobresale en escenarios donde se necesita conectar de forma instantánea decenas de integraciones heredadas sin escribir adaptadores, Pydantic AI ofrece una base mucho más sólida para arquitecturas de microservicios donde la previsibilidad de los datos es un requisito no negociable.
¿Cómo queda el código de un agente simple en ambas herramientas?
Para comprender el impacto de estas decisiones arquitectónicas en el día a día del desarrollo, vale la pena analizar cómo se implementa un agente con soporte para llamadas a herramientas (tool calling) y retorno estructurado en ambas plataformas. El objetivo del siguiente código es consultar el estado de un pedido en un sistema interno y retornar una respuesta estrictamente validada.
Primero, veamos un enfoque típico utilizando LangChain, donde es necesario configurar el modelo, definir la herramienta mediante un decorador específico e integrar la ejecución a través de un agente estructurado:
from langchain_core.tools import tool
from langchain_openai import ChatOpenAI
from langchain.agents import AgentExecutor, create_tool_calling_agent
from langchain_core.prompts import ChatPromptTemplate, MessagesPlaceholder
from pydantic import BaseModel, Field

class StatusPedido(BaseModel):
    id_pedido: str = Field(description="Identificador unico del pedido")
    status: str = Field(description="Estado actual del procesamiento")
    dias_entrega: int = Field(description="Prazo estimado em dias")

@tool
def buscar_status_sistema(id_pedido: str) -> dict:
    """Consulta la base de datos interna para obtener datos del pedido."""
    # Simulación de consulta a la base de datos
    return {"id_pedido": id_pedido, "status": "em_transito", "dias_entrega": 3}

llm = ChatOpenAI(model="gpt-4o-mini", temperature=0)
tools = [buscar_status_sistema]

prompt = ChatPromptTemplate.from_messages([
    ("system", "Eres un asistente de soporte logistico eficiente."),
    ("human", "{input}"),
    MessagesPlaceholder(variable_name="agent_scratchpad"),
])

agente = create_tool_calling_agent(llm, tools, prompt)
executor = AgentExecutor(agent_agent=agente, tools=tools, verbose=False)

resposta = executor.invoke({"input": "¿Cuál es el estado del pedido PED-9942?"})
print(resposta["output"])
Nota que en el ejemplo de LangChain la integración entre las herramientas, el prompt y el manejador requiere la construcción del AgentExecutor, además de tratar entradas y salidas como diccionarios genéricos, perdiendo el chequeo de tipos estático en la respuesta final retornada al solicitante.
Ahora, observa cómo la misma funcionalidad se implementa con Pydantic AI en Python 3.14.7, aprovechando el tipado genérico para definir la salida estructurada directamente en la firma del agente:
from dataclasses import dataclass
from pydantic import BaseModel, Field
from pydantic_ai import Agent, RunContext

class StatusPedido(BaseModel):
    id_pedido: str = Field(description="Identificador unico del pedido")
    status: str = Field(description="Estado actual del procesamiento")
    dias_entrega: int = Field(description="Prazo estimado em dias")

@dataclass
class DependenciasConexao:
    url_banco: str

agente = Agent[
    DependenciasConexao, StatusPedido
](
    "openai:gpt-4o-mini",
    result_type=StatusPedido,
    system_prompt="Eres un asistente de soporte logistico eficiente.",
)

@agente.tool
async def buscar_status_sistema(ctx: RunContext[DependenciasConexao], id_pedido: str) -> dict:
    """Consulta la base de datos interna para obtener datos del pedido."""
    # Acceso seguro a dependencias inyectadas via contexto tipado
    _ = ctx.deps.url_banco
    return {"id_pedido": id_pedido, "status": "em_transito", "dias_entrega": 3}

deps = DependenciasConexao(url_banco="postgresql://localhost:5432/logistica")
resultado = agente.run_sync("¿Cuál es el estado del pedido PED-9942?", deps=deps)

# El resultado es una instancia validada de StatusPedido con soporte total de la IDE
status_final: StatusPedido = resultado.data
print(f"Pedido {status_final.id_pedido}: {status_final.status} (Prazo: {status_final.dias_entrega} dias)")
La comparación visual del código deja clara la diferencia pragmática: Pydantic AI trata la respuesta de la LLM como un tipo garantizado (StatusPedido). Si el modelo retorna un campo inválido, Pydantic AI rechaza la respuesta y puede disparar automáticamente un nuevo ciclo de ajuste orientando al modelo sobre el error de validación, sin que tengas que escribir un manejador de excepciones complejo.
¿Cuál es el consumo de memoria y la latencia de cada framework?
En entornos de producción con alto volumen de peticiones por segundo, el tiempo de inicio en frío (cold start) y el consumo de memoria de un microservicio son factores determinantes para el costo de infraestructura. LangChain, debido a su vasto ecosistema de subpaquetes y conectores, posee un árbol de dependencias considerable. Importar el paquete principal de LangChain en una función serverless o contenedor de microservicio puede agregar cientos de milisegundos solo en la carga de los módulos en la memoria RAM.
Por su parte, Pydantic AI se beneficia de la arquitectura extremadamente optimizada de Pydantic V2. La validación de tipos y la conversión de cargas útiles JSON enviadas y recibidas desde las API de los proveedores (como OpenAI, Anthropic o modelos locales ejecutándose vía Ollama) ocurren con código compilado nativamente. Esto resulta en una huella de memoria significativamente menor y un tiempo de respuesta donde el cuello de botella es puramente la latencia de red de la propia LLM, eliminando la sobrecarga (overhead) del procesamiento interno del framework.
Otro punto crucial de rendimiento es la gestión de llamadas concurrentes. Pydantic AI fue construido desde el primer día adoptando los patrones asíncronos modernos de Python (async/await). Mientras que LangChain añadió soporte asíncrono a lo largo del tiempo sobre una base histórica síncrona, Pydantic AI ofrece ejecución asíncrona nativa, facilitando el encadenamiento de múltiples agentes y llamadas paralelas a herramientas sin bloquear el event loop de la aplicación.
En el aspecto de observabilidad, ambos proporcionan soporte para el rastreo de llamadas. LangChain se integra de forma nativa con la plataforma propietaria LangSmith, la cual exige una cuenta y configuración de claves para una experiencia completa. Pydantic AI adopta el estándar abierto OpenTelemetry a través de Pydantic Logfire, permitiendo exportar trazas de ejecución directamente a cualquier proveedor de monitoreo del mercado (como Datadog, Grafana o OpenTelemetry Collector) sin acoplamiento a un proveedor específico.
¿Cuál es la mejor elección para tu proyecto en 2026?
La decisión sobre qué tecnología adoptar debe estar fundamentada en el alcance de la aplicación y la madurez del equipo de desarrollo. Ninguna herramienta es una solución universal, y entender los escenarios donde cada una se destaca previene refactorizaciones costosas en el futuro.
Elige LangChain cuando:
- Estés construyendo prototipos rápidos que necesitan conectar decenas de fuentes de datos heterogéneas y bases de datos vectoriales donde ya existen adaptadores listos en LangChain Community.
- Tu proyecto exija la construcción de flujos de estados no lineales y grafos altamente complejos a través del ecosistema LangGraph, aprovechando los conectores de persistencia de estado nativos de esta suite.
- El equipo ya cuente con una infraestructura consolidada alrededor de LangSmith para depurar y monitorear ejecuciones de prompts a gran escala.
Elige Pydantic AI cuando:
- Estés desarrollando microservicios críticos en Python 3.14.7 donde el tipado estático, la validación de contratos y la estabilidad del código sean prioridades absolutas.
- Tu aplicación ya haga uso extensivo de Pydantic y FastAPI, permitiendo reutilizar esquemas de bases de datos y rutas HTTP directamente en las definiciones de agentes de IA.
- Sea fundamental mantener un código limpio, fácil de probar con pruebas unitarias convencionales (
pytest) y sin acoplamiento a abstracciones propietarias pesadas. - El enfoque sea el bajo consumo de recursos, inicio rápido en contenedores y exportación de métricas mediante estándares abiertos de observabilidad.
Conclusión
La evolución de las herramientas de desarrollo refleja la transición de la fase de experimentación hacia la ingeniería de software rigurosa en el campo de la inteligencia artificial. En el análisis comparativo de pydantic ai vs langchain, queda claro que la industria se mueve hacia abstracciones más livianas, transparentes y fuertemente tipadas. Mientras que LangChain continúa siendo una suite robusta para explorar flujos complejos basados en grafos con una vasta biblioteca de integraciones listas, Pydantic AI establece el nuevo estándar de elegancia y previsibilidad para sistemas orientados a microservicios en Python. Evaluar la complejidad de tu proyecto y el nivel de control de tipos exigido determinará cuál de los dos enfoques garantizará la mejor arquitectura a largo plazo.