DeepSeek-R1 vs Llama 3.3: qual escolher em 2026?
Entenda as diferenças de arquitetura, consumo de VRAM e performance entre DeepSeek-R1 vs Llama 3.3 para decidir o modelo ideal para seu servidor local.
A execução local de modelos de linguagem de grande porte deixou de ser uma experiência de laboratório e se tornou requisito de segurança e custos para equipes de engenharia de software. Ao comparar o deepseek-r1 vs llama 3.3, desenvolvedores e arquitetos de soluções se deparam com duas filosofias opostas de inteligência artificial: de um lado, a abordagem de raciocínio encadeado longo (chain-of-thought) otimizada por aprendizado por reforço; do outro, a robustez de um modelo denso altamente refinado para seguir instruções diretas.
Rodar esses modelos em servidores locais no ecossistema Python 3.14.7 envolve entender não apenas os limites de memória da GPU, mas também o comportamento de throughput, latência do primeiro token (TTFT) e o padrão de resposta esperado pelas aplicações corporativas. Este artigo analisa os dois modelos em cenários reais de inferência local, avaliando infraestrutura, consumo e adequação prática.
Por que a escolha do modelo local mudou em 2026?
Até pouco tempo atrás, a escolha de um modelo open-weights para inferência local se resumia à contagem bruta de parâmetros e ao tamanho da janela de contexto. Em 2026, a emergência de modelos especialistas em raciocínio (reasoning models) alterou fundamentalmente o fluxo de inferência. Modelos como o DeepSeek-R1 não entregam apenas uma resposta final imediata; eles alocam orçamento computacional durante a inferência para explorar hipóteses, testar caminhos lógicos e corrigir o próprio raciocínio antes de gerar o texto conclusivo.
Por outro lado, modelos como o Llama 3.3 de 70B parâmetros mantêm a abordagem tradicional de alta densidade e resposta direta, destacando-se pela capacidade preditiva rápida, excelente suporte a múltiplos idiomas e estrita observância de instruções estruturadas em chamadas de função (function calling). Escolher a ferramenta errada para seu pipeline pode resultar em custos desnecessários de hardware ou em latências incompatíveis com a experiência do usuário.
Como comparar DeepSeek-R1 vs Llama 3.3 em servidores locais?
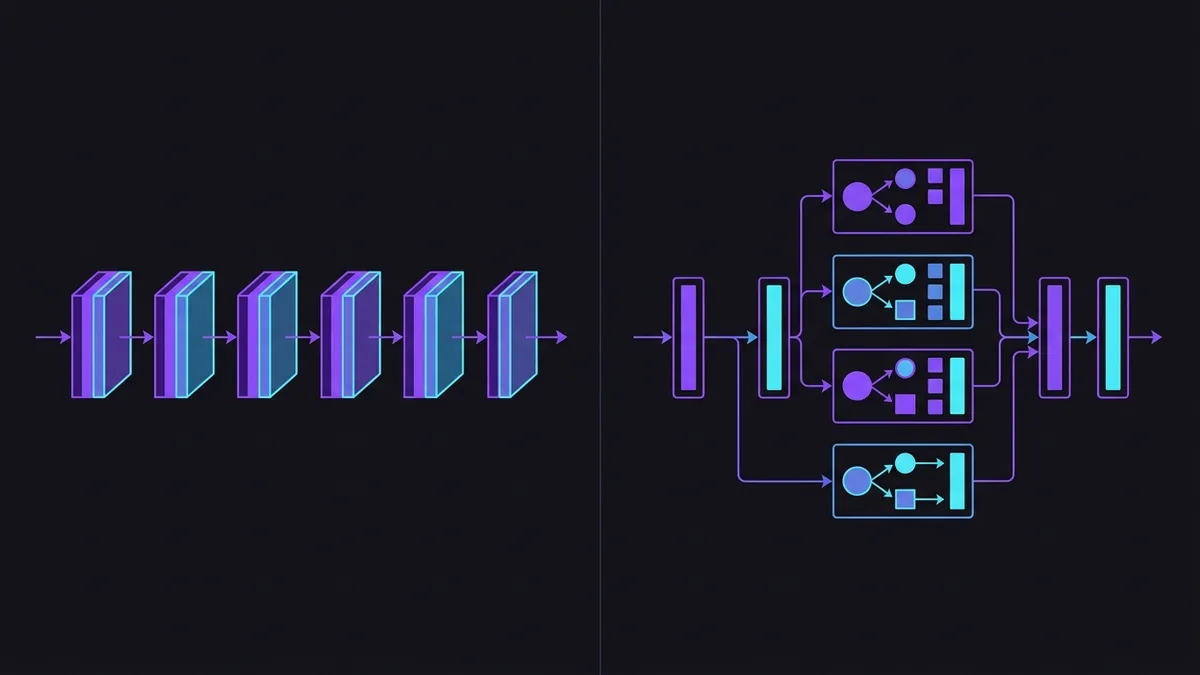
Para estabelecer uma comparação justa entre o deepseek-r1 vs llama 3.3, precisamos avaliar critérios de engenharia de infraestrutura e utilidade prática no dia a dia do desenvolvimento. Não basta comparar pontuações em benchmarks genéricos; é preciso analisar o comportamento em produção sob gerentes de inferência como vLLM e Ollama.
| Critério de Avaliação | DeepSeek-R1 (671B / Distillations) | Meta Llama 3.3 (70B) |
|---|---|---|
| Arquitetura Principal | Mixture of Experts (MoE) / Chain-of-Thought | Transformer Denso |
| Foco de Otimização | Raciocínio matemático, lógica e código complexo | Instrução geral, resumo e estruturação JSON |
| Consumo Típico de VRAM | Variável (37B ativos no full / 5.2GB a 43GB em versões distill) | ~40GB a 48GB (quantizado em FP8/INT4) |
| Comportamento de Saída | Gera bloco <think> antes do resultado |
Resposta direta e imediata ao prompt |
| Suporte a Function Calling | Moderado (requer parsing de cadeias de raciocínio) | Excelente e nativamente treinado |
A diferença fundamental reside na forma como os tokens são processados. Enquanto o Llama 3.3 utiliza todos os seus 70 bilhões de parâmetros a cada token gerado, o DeepSeek-R1 original utiliza uma arquitetura Mixture of Experts (MoE) com 671B de parâmetros totais, mas ativando apenas 37B por token. Para infraestruturas com recursos limitados, as versões destiladas do DeepSeek-R1 (baseadas em Llama e Qwen, variando de 8B a 70B) trazem a dinâmica de raciocínio para placas de vídeo de nível de entrada e intermediário.
Qual a diferença de arquitetura entre R1 e Llama 3.3?
A arquitetura do Llama 3.3 70B representa o ápice dos modelos Transformers densos convencionais. Cada camada da rede processa o vetor de entrada através de todas as matrizes de atenção e feed-forward. Isso resulta em um tempo de processamento por token altamente previsível e determinístico, o que facilita o dimensionamento de cargas de trabalho concorrentes em clusters com vLLM.
O DeepSeek-R1, em sua versão completa, utiliza um sistema de roteamento dinâmico que direciona o fluxo de dados para especialistas específicos (experts). Além disso, o seu treinamento via aprendizado por reforço em larga escala sem supervisão humana direta introduziu a capacidade intrínseca de reflexão. Na prática, ao receber uma tarefa complexa de programação, o modelo gera uma sequência interna de tokens envolvida na tag <think>:
<think>
O usuário pediu uma função Python para resolver o problema do caixeiro viajante usando programação dinâmica.
Primeiro, preciso verificar as restrições de memória para N <= 16.
A abordagem por máscara de bits O(N^2 * 2^N) é adequada.
Devo garantir que o tipo de retorno seja explicitamente tipado com type hints do Python 3.14.
</think>

def tsp_dp(graph: list[list[int]]) -> int:
    ...
Essa fase de raciocínio aumenta significativamente o número de tokens gerados por requisição. Se a sua aplicação cobra por token de saída ou precisa responder a chamadas HTTP síncronas com tempo limite curto, o modelo de raciocínio pode causar timeouts se o pipeline não for ajustado.
Como medir o consumo de VRAM e o desempenho em Python?
Para integrar esses modelos em ecossistemas Python modernos, a escolha da biblioteca de inferência define a eficiência de memória. O vLLM oferece suporte avançado a PagedAttention e Prefix Caching, essenciais para reaproveitar contextos em conversas longas.
Abaixo, um exemplo prático de servidor de inferência configurado em Python 3.14 para carregar e comparar as respostas dos modelos utilizando a API unificada do vLLM:
```python rest_client.py import asyncio from openai import AsyncOpenAI
Cliente apontando para a instância local do vLLM / Ollama
client = AsyncOpenAI( base_url="http://localhost:8000/v1", api_key="ollama-local" )
async def test_inference(model_name: str, prompt: str) -> None: print(f"--- Testando modelo: {model_name} ---") response = await client.chat.completions.create( model=model_name, messages=[ {"role": "system", "content": "Você é um assistente técnico sênior de desenvolvimento em Python."}, {"role": "user", "content": prompt} ], temperature=0.6 )
content = response.choices[0].message.content
print(content)
async def main(): prompt = "Escreva uma classe em Python 3.14 usando dataclasses para gerenciar uma fila concorrente com asyncio."
# Comparando o modelo de raciocínio vs o modelo denso tradicional
await test_inference("deepseek-r1:8b", prompt)
await test_inference("llama3.3:70b", prompt)
if name == "main": asyncio.run(main()) ```
Ao executar esse código, observa-se que o deepseek-r1:8b consome aproximadamente 5.2 GB de VRAM em quantização de 4 bits, tornando-o viável para GPUs de consumidor (como uma RTX 4060 ou 5060). No entanto, o tempo total de resposta pode ser maior devido aos tokens de reflexão.
O llama3.3:70b, por sua vez, requer no mínimo 40 GB a 48 GB de VRAM para rodar com quantização INT4/FP8 em GPUs profissionais (como uma A100/H100 ou duas RTX 3090/4090 emparelhadas via NVLink). O tempo até o primeiro token é menor, e a resposta é gerada sem a sobrecarga do bloco <think>.
Qual a melhor opção para pipelines de automação e RAG?
Em arquiteturas de Retrieval-Augmentation Generation (RAG) e sistemas de agentes autônomos, o comportamento do modelo sob dados ruidosos determina o sucesso do sistema.
Use o Llama 3.3 quando:
- Seu pipeline depende estritamente do formato JSON nativo para integrar com APIs REST ou bancos de dados PostgreSQL 18.6.
- O sistema realiza tarefas de extração de informação, sumarização de documentos e atendimento ao cliente em tempo real.
- Você tem infraestrutura de hardware suficiente para alocar modelos de 70B parâmetros.
Use o DeepSeek-R1 (ou suas versões Distill) quando:
- A aplicação resolve problemas matemáticos, análise estática de código complexo ou refatoração de arquiteturas de software.
- A precisão lógica é mais importante do que a latência de resposta inicial.
- O hardware local é limitado e você precisa rodar instâncias distill eficientes de 8B ou 14B parâmetros com alta capacidade analítica.
Qual o veredito prático para a sua pilha de desenvolvimento?
A escolha entre os dois modelos não precisa ser mutuamente exclusiva em uma infraestrutura corporativa modernizada. Muitas equipes adotam uma abordagem híbrida de roteamento de solicitações: requisições simples e chamadas de ferramentas (tool use) são direcionadas ao Llama 3.3, enquanto tarefas de depuração profunda, auditoria de segurança e geração de algoritmos complexos são enviadas ao DeepSeek-R1.
Ao planejar seu servidor local em 2026, certifique-se de manter os drivers de GPU atualizados e utilizar o vLLM com suporte a carregamento dinâmico de adaptadores para otimizar a alocação de recursos.
Conclusão
Determinar o vencedor no confronto deepseek-r1 vs llama 3.3 depende essencialmente da natureza do seu problema computacional. O Llama 3.3 continua sendo a referência em versatilidade, robustez de instrução e velocidade para fluxos de trabalho tradicionais. Por outro lado, o DeepSeek-R1 redefine o patamar de inteligência analítica local, permitindo que modelos menores entreguem capacidades de raciocínio antes restritas a APIs proprietárias de alto custo. Avalie sua disponibilidade de VRAM, meça a latência tolerável por seus usuários e implemente o modelo que melhor equilibre custo operacional e precisão técnica.