DeepSeek-R1 vs Llama 3.3: ¿cuál elegir en 2026?
Compara DeepSeek-R1 vs Llama 3.3: diferencias de arquitectura, consumo de VRAM y rendimiento para elegir el modelo ideal para tu servidor local.
La ejecución local de modelos de lenguaje de gran tamaño dejó de ser un experimento de laboratorio y se convirtió en un requisito de seguridad y costos para equipos de ingeniería de software. Al comparar deepseek-r1 vs llama 3.3, desarrolladores y arquitectos de soluciones se enfrentan a dos filosofías opuestas de inteligencia artificial: por un lado, el enfoque de razonamiento encadenado largo (chain-of-thought) optimizado mediante aprendizaje por refuerzo; por el otro, la robustez de un modelo denso altamente refinado para seguir instrucciones directas.
Ejecutar estos modelos en servidores locales en el ecosistema Python 3.14.7 implica entender no solo los límites de memoria de la GPU, sino también el comportamiento de throughput, la latencia del primer token (TTFT) y el patrón de respuesta esperado por las aplicaciones empresariales. Este artículo analiza ambos modelos en escenarios reales de inferencia local, evaluando infraestructura, consumo y adecuación práctica.
¿Por qué la elección del modelo local cambió en 2026?
Hasta hace poco, elegir un modelo de pesos abiertos (open-weights) para inferencia local se reducía al conteo bruto de parámetros y al tamaño de la ventana de contexto. En 2026, la emergencia de modelos especializados en razonamiento (reasoning models) alteró fundamentalmente el flujo de inferencia. Modelos como DeepSeek-R1 no entregan solo una respuesta final inmediata; asignan presupuesto computacional durante la inferencia para explorar hipótesis, probar caminos lógicos y corregir su propio razonamiento antes de generar el texto conclusivo.
Por otro lado, modelos como Llama 3.3 de 70B parámetros mantienen el enfoque tradicional de alta densidad y respuesta directa, destacándose por su capacidad predictiva rápida, excelente soporte para múltiples idiomas y estricta observancia de instrucciones estructuradas en llamadas a funciones (function calling). Elegir la herramienta equivocada para tu pipeline puede resultar en costos innecesarios de hardware o en latencias incompatibles con la experiencia del usuario.
¿Cómo comparar DeepSeek-R1 vs Llama 3.3 en servidores locales?
Para establecer una comparación justa en el escenario deepseek-r1 vs llama 3.3, debemos evaluar criterios de ingeniería de infraestructura y utilidad práctica en el desarrollo diario. No basta con comparar puntuaciones en benchmarks genéricos; es necesario analizar el comportamiento en producción bajo gestores de inferencia como vLLM y Ollama.
| Criterio de evaluación | DeepSeek-R1 (671B / Destilaciones) | Meta Llama 3.3 (70B) |
|---|---|---|
| Arquitectura principal | Mixture of Experts (MoE) / Chain-of-Thought | Transformer denso |
| Enfoque de optimización | Razonamiento matemático, lógica y código complejo | Instrucción general, resumen y estructuración JSON |
| Consumo típico de VRAM | Variable (37B activos en la versión completa / 5.2 GB a 43 GB en versiones destiladas) | ~40 GB a 48 GB (cuantizado en FP8/INT4) |
| Comportamiento de salida | Genera un bloque <think> antes del resultado |
Respuesta directa e inmediata al prompt |
| Soporte para Function Calling | Moderado (requiere parsing de cadenas de razonamiento) | Excelente y entrenado de forma nativa |
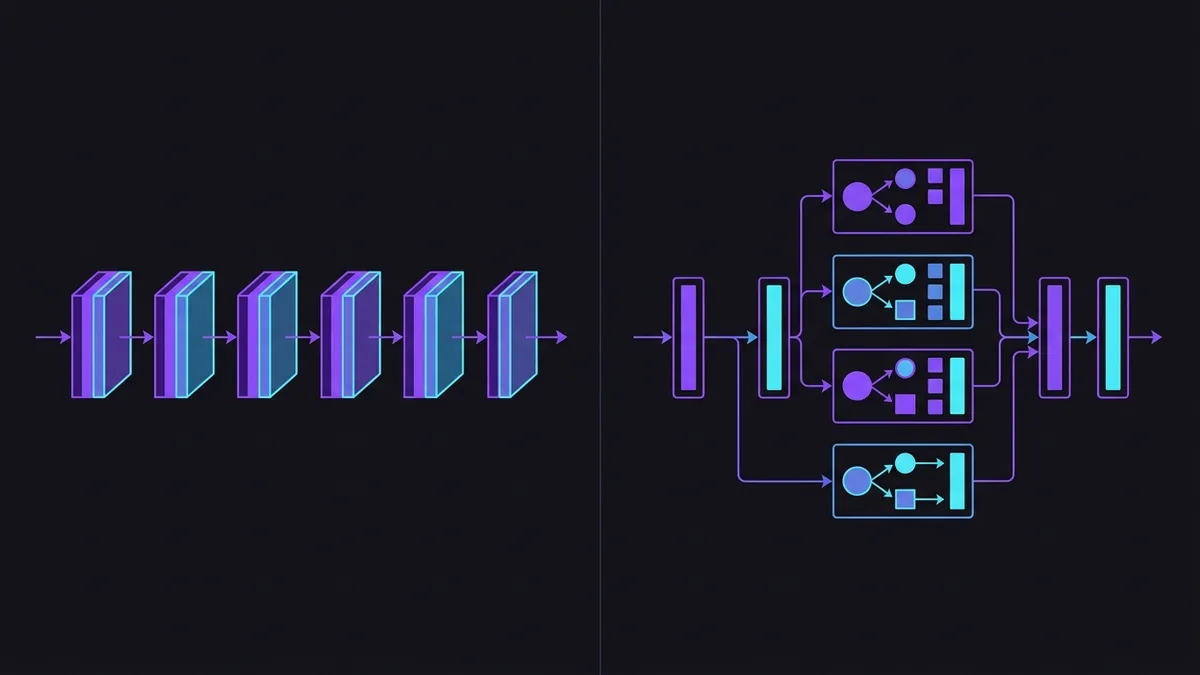
La diferencia fundamental reside en la forma en que se procesan los tokens. Mientras que Llama 3.3 utiliza todos sus 70 mil millones de parámetros por cada token generado, el DeepSeek-R1 original utiliza una arquitectura Mixture of Experts (MoE) con 671B de parámetros totales, pero activando solo 37B por token. Para infraestructuras con recursos limitados, las versiones destiladas de DeepSeek-R1 (basadas en Llama y Qwen, que varían de 8B a 70B) llevan la dinámica de razonamiento a tarjetas de video de gama de entrada y media.
¿Cuál es la diferencia de arquitectura entre R1 y Llama 3.3?
La arquitectura de Llama 3.3 70B representa la cúspide de los modelos Transformers densos convencionales. Cada capa de la red procesa el vector de entrada a través de todas las matrices de atención y feed-forward. Esto genera un tiempo de procesamiento por token altamente predecible y determinista, lo que facilita el dimensionamiento de cargas de trabajo concurrentes en clusters con vLLM.
DeepSeek-R1, en su versión completa, utiliza un sistema de enrutamiento dinámico que dirige el flujo de datos hacia expertos específicos (experts). Además, su entrenamiento mediante aprendizaje por refuerzo a gran escala sin supervisión humana directa introdujo la capacidad intrínseca de reflexión. En la práctica, al recibir una tarea compleja de programación, el modelo genera una secuencia interna de tokens envuelta en la etiqueta <think>:
<think>
El usuario pidió una función en Python para resolver el problema del viajante de comercio usando programación dinámica.
Primero, necesito verificar las restricciones de memoria para N <= 16.
El enfoque por máscara de bits O(N^2 * 2^N) es adecuado.
Debo garantizar que el tipo de retorno esté explícitamente tipado con type hints de Python 3.14.
</think>

def tsp_dp(graph: list[list[int]]) -> int:
    ...
Esta fase de razonamiento aumenta significativamente el número de tokens generados por petición. Si tu aplicación cobra por token de salida o necesita responder a llamadas HTTP sincrónicas con un tiempo de espera ajustado (timeout), el modelo de razonamiento puede causar fallos si el pipeline no se configura adecuadamente.
¿Cómo medir el consumo de VRAM y el rendimiento en Python?
Para integrar estos modelos en ecosistemas modernos de Python, la elección de la librería de inferencia define la eficiencia de la memoria. vLLM ofrece soporte avanzado para PagedAttention y Prefix Caching, fundamentales para reutilizar contextos en conversaciones largas.
A continuación, un ejemplo práctico de servidor de inferencia configurado en Python 3.14 para cargar y comparar las respuestas de los modelos utilizando la API unificada de vLLM:
```python rest_client.py import asyncio from openai import AsyncOpenAI
Cliente apuntando a la instancia local de vLLM / Ollama
client = AsyncOpenAI( base_url="http://localhost:8000/v1", api_key="ollama-local" )
async def test_inference(model_name: str, prompt: str) -> None: print(f"--- Probando modelo: {model_name} ---") response = await client.chat.completions.create( model=model_name, messages=[ {"role": "system", "content": "Eres un asistente técnico sénior de desarrollo en Python."}, {"role": "user", "content": prompt} ], temperature=0.6 )
content = response.choices[0].message.content
print(content)
async def main(): prompt = "Escribe una clase en Python 3.14 usando dataclasses para gestionar una cola concurrente con asyncio."
# Comparando el modelo de razonamiento vs el modelo denso tradicional
await test_inference("deepseek-r1:8b", prompt)
await test_inference("llama3.3:70b", prompt)
if name == "main": asyncio.run(main()) ```
Al ejecutar este código, se observa que deepseek-r1:8b consume aproximadamente 5.2 GB de VRAM con cuantización de 4 bits, lo que lo hace viable para tarjetas gráficas de consumo (como una RTX 4060 o 5060). Sin embargo, el tiempo total de respuesta puede ser mayor debido a los tokens de reflexión.
Por su parte, llama3.3:70b requiere un mínimo de 40 GB a 48 GB de VRAM para ejecutarse con cuantización INT4/FP8 en GPU profesionales (como una A100/H100 o dos RTX 3090/4090 conectadas vía NVLink). El tiempo hasta el primer token es menor y la respuesta se genera sin la sobrecarga del bloque <think>.
¿Cuál es la mejor opción para pipelines de automatización y RAG?
En arquitecturas de generación aumentada por recuperación (Retrieval-Augmented Generation o RAG) y sistemas de agentes autónomos, el comportamiento del modelo frente a datos con ruido determina el éxito del sistema.
Usa Llama 3.3 cuando:
- Tu pipeline depende estrictamente del formato JSON nativo para integrarse con API REST o bases de datos PostgreSQL 18.6.
- El sistema realiza tareas de extracción de información, resumen de documentos y atención al cliente en tiempo real.
- Cuentas con la infraestructura de hardware suficiente para alojar modelos de 70B parámetros.
Usa DeepSeek-R1 (o sus versiones Distill) cuando:
- La aplicación resuelve problemas matemáticos, análisis estático de código complejo o refactorización de arquitecturas de software.
- La precisión lógica es más importante que la latencia de respuesta inicial.
- El hardware local es limitado y necesitas ejecutar instancias destiladas eficientes de 8B o 14B parámetros con alta capacidad analítica.
¿Cuál es el veredicto práctico para tu stack de desarrollo?
La elección entre ambos modelos no tiene por qué ser mutuamente excluyente en una infraestructura empresarial modernizada. Muchos equipos adoptan un enfoque híbrido de enrutamiento de peticiones: las solicitudes sencillas y el uso de herramientas (tool use) se dirigen a Llama 3.3, mientras que las tareas de depuración profunda, auditorías de seguridad y generación de algoritmos complejos se envían a DeepSeek-R1.
Al planificar tu servidor local en 2026, asegúrate de mantener actualizados los controladores de GPU y utilizar vLLM con soporte para carga dinámica de adaptadores para optimizar la asignación de recursos.
Conclusión
Determinar el ganador en la comparativa deepseek-r1 vs llama 3.3 depende esencialmente de la naturaleza de tu problema computacional. Llama 3.3 sigue siendo la referencia en versatilidad, robustez al seguir instrucciones y velocidad para flujos de trabajo tradicionales. Por otro lado, DeepSeek-R1 redefine el estándar de inteligencia analítica local, permitiendo que modelos más pequeños entreguen capacidades de razonamiento que antes estaban restringidas a API propietarias de alto costo. Evalúa tu disponibilidad de VRAM, mide la latencia tolerable por tus usuarios e implementa el modelo que mejor equilibre el costo operativo y la precisión técnica.