Evita bloqueos al limitar cpu y memoria con cgroups v2
Aprende a limitar cpu y memoria con cgroups v2 en Linux para proteger servidores contra cuelgues. Guía práctica con systemd y Python.
Cuando una aplicación en Python 3.14.7 entra en un bucle infinito o un script de procesamiento en lote intenta cargar un conjunto de datos mayor que la memoria RAM física disponible, las consecuencias para el servidor suelen ser catastróficas. Sin un aislamiento adecuado, un solo proceso descontrolado consume toda la CPU del sistema, agota la memoria swap y provoca el congelamiento completo del entorno, lo que requiere intervenciones manuales drásticas. La solución definitiva para mantener la estabilidad y la previsibilidad operativa en distribuciones modernas es limitar cpu y memoria con cgroups v2, el mecanismo unificado de control de recursos del kernel Linux.
Históricamente, la gestión de recursos en Linux sufría por la complejidad y la falta de coordinación entre los subsistemas de control. El mecanismo cgroups v2 resuelve este problema al reorganizar todo el árbol de procesos bajo una arquitectura de jerarquía única. Ya sea para aislar microservicios ejecutándose en Ubuntu 26.04.1, restringir contenedores temporales o proteger bases de datos como PostgreSQL 18.6 contra la concurrencia predatoria, dominar las herramientas de cgroups v2 junto a systemd es una competencia indispensable para cualquier desarrollador o administrador de sistemas.
¿Por qué el modelo unificado de cgroups v2 reemplazó a v1?
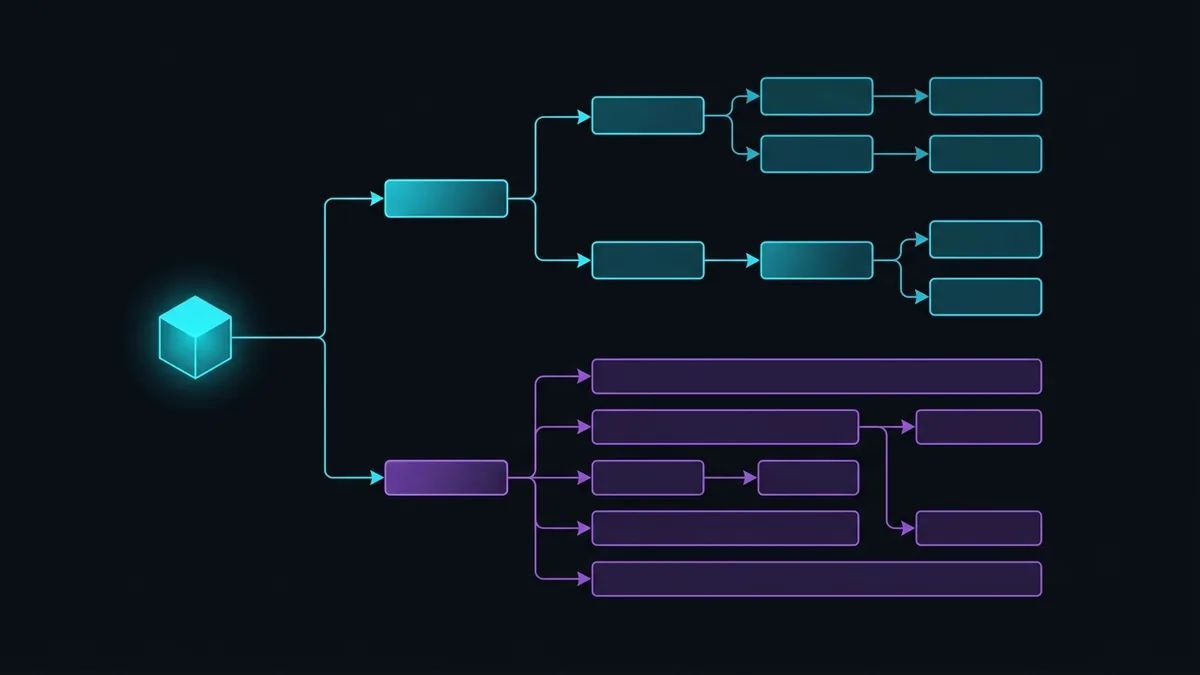
La transición de la versión 1 a la versión 2 de cgroups no fue solo una simple mejora incremental, sino una profunda reformulación estructural en el kernel Linux. En cgroups v1, cada subsistema de recursos —como CPU, memoria, I/O de disco y red— poseía su propio árbol de directorios independiente en /sys/fs/cgroup. Esta independencia generaba un grave problema de inconsistencia: un mismo proceso podía pertenecer a un grupo específico en el árbol de CPU, pero estar asociado a un grupo completamente diferente en el árbol de memoria.
Esta falta de unificación producía condiciones de carrera, bloqueos difíciles de depurar y fallas crónicas en el control de entrada y salida. Por ejemplo, cuando el kernel intentaba aplicar límites de I/O a un proceso, con frecuencia no lograba rastrear qué páginas de memoria en caché pertenecían a ese grupo, lo que resultaba en escrituras descontroladas en disco que ignoraban las restricciones impuestas. Además, el comportamiento del OOM Killer (Out Of Memory Killer) en cgroups v1 era impredecible, eliminando muchas veces procesos críticos del sistema operativo en lugar de finalizar únicamente la aplicación que excedía la cuota.
cgroups v2 resolvió esta desorganización al implementar el principio del modelo de jerarquía unificada. En este nuevo enfoque, cada proceso del sistema pertenece a exactamente un único nodo en el árbol de cgroups. La estructura refleja directamente el árbol de procesos del sistema, garantizando que el control de CPU, memoria, I/O e hilos ocurra bajo el mismo contexto jerárquico. Los controladores de recursos se habilitan explícitamente en cada nivel mediante el archivo de interfaz cgroup.subtree_control.
Otra innovación crucial de cgroups v2 es la métrica PSI (Pressure Stall Information). PSI permite que el kernel y los daemons de monitoreo midan con precisión y en tiempo real cuánto tiempo de ejecución pierden las tareas debido a la falta de CPU, memoria o I/O de disco. Respecto a la gestión de memoria, la versión 2 introdujo una distinción clara entre dos límites esenciales:
memory.high: Funciona como un límite suave de estrangulamiento. Cuando el consumo de RAM del grupo supera este valor, el sistema no interrumpe el proceso de inmediato. En su lugar, el kernel desacelera la asignación de memoria y fuerza al proceso a liberar páginas en caché o entrar en estado de espera, aplicando un freno preventivo.memory.max: Representa el límite estricto de asignación. Si el grupo alcanza este techo y no hay memoria física o espacio de swap recuperable, el OOM Killer se activa específicamente para ese grupo de control, finalizando la tarea ofensora sin afectar a los demás servicios de la computadora.
Esta arquitectura integrada garantiza que la limitación de recursos ocurra de forma predecible y segura, haciendo que la infraestructura sea mucho más resistente ante picos imprevistos de carga.
¿Cómo configurar Linux para limitar cpu y memoria con cgroups v2?
Para verificar si tu sistema operativo ya opera completamente con cgroups v2, basta con comprobar el tipo de sistema de archivos montado en el directorio /sys/fs/cgroup. En distribuciones actuales, como Debian 13.7 y Ubuntu 26.04.1, la versión 2 está activada por defecto tras la instalación. Ejecutando un comando sencillo de verificación en la terminal, confirma el montaje:
stat -f -c %T /sys/fs/cgroup
Si la respuesta es cgroup2fs, la jerarquía unificada está activa y lista para usarse. De lo contrario, puedes configurar el cambio añadiendo el parámetro systemd.unified_cgroup_hierarchy=1 en la línea de comandos del cargador de arranque GRUB y reiniciando el equipo.
Aunque en entornos de producción lo recomendado es usar la gestión integrada mediante systemd, comprender cómo interactuar directamente con la interfaz pseudo-filesystem del kernel es fundamental para entender el funcionamiento interno del mecanismo. En el directorio /sys/fs/cgroup, crear un nuevo grupo de control equivale a crear un directorio simple.
A continuación se muestra una demostración práctica de cómo crear un cgroup manual para limitar cpu y memoria con cgroups v2 en un script de pruebas:
# Creación del nodo jerárquico para la aplicación
sudo mkdir -p /sys/fs/cgroup/meu_servico_teste

# Habilitación de controladores de CPU y memoria
echo "+cpu +memory" | sudo tee /sys/fs/cgroup/cgroup.subtree_control

# Definición del límite máximo de memoria a 512 Megabytes (en bytes)
echo "536870912" | sudo tee /sys/fs/cgroup/meu_servico_teste/memory.max

# Definición de cuota de CPU (formato: cuota período, en microsegundos)
# El valor 50000 100000 limita el uso al 50% de un solo núcleo de CPU
echo "50000 100000" | sudo tee /sys/fs/cgroup/meu_servico_teste/cpu.max
Una vez definidos los archivos de control en el directorio creado, cualquier proceso puede trasladarse a este grupo escribiendo su PID (Process ID) en el archivo de interfaz cgroup.procs:
# Vinculando el shell actual al cgroup restringido
echo $$ | sudo tee /sys/fs/cgroup/meu_servico_teste/cgroup.procs
Desde el momento en que se registra el PID, todos los procesos hijo generados por este shell heredarán automáticamente las restricciones impuestas. Si un script en Python intenta asignar un arreglo gigante que supere los 512 MB configurados en memory.max, el OOM Killer del kernel actuará estrictamente dentro del grupo meu_servico_teste, manteniendo intacta la estabilidad global del sistema.
¿Cómo usar systemd-run para limitar recursos en scripts sin reiniciar el servidor?
Manipular archivos directamente en el directorio /sys/fs/cgroup durante el funcionamiento normal de un servidor no es la práctica más recomendada en el ecosistema moderno. Como systemd actúa como el gestor primario de init y de cgroups en Linux, crear directorios manuales puede causar conflictos de propiedad en el árbol de cgroups. Para ejecutar comandos ad-hoc y tareas puntuales sujetas a restricciones de recursos sin necesidad de editar archivos de servicio permanentes, la utilidad systemd-run es la solución perfecta.
systemd-run crea una unidad transitoria (una unidad temporal gestionada directamente en la memoria de systemd) que envuelve la ejecución del comando deseado en un ámbito totalmente aislado. Esto resulta sumamente útil para rutinas de mantenimiento, pipelines de ciencia de datos en Python o tareas periódicas.
La sintaxis para definir límites dinámicos con systemd-run es directa e intuitiva. A continuación puedes ver un ejemplo real limitando una tarea pesada de procesamiento:
systemd-run --scope \
  -p MemoryMax=1G \
  -p MemoryHigh=800M \
  -p CPUQuota=150% \
  -p TasksMax=50 \
  python3 script_processamento.py
Examinando detalladamente cada parámetro aplicado al comando:
--scope: Informa a systemd que ejecute el comando en el mismo contexto del proceso actual, en lugar de crear un servicio en segundo plano (daemon).MemoryMax=1G: Mapea directamente a la directivamemory.maxde cgroups v2, estableciendo el límite estricto de 1 Gigabyte de memoria RAM.MemoryHigh=800M: Mapea a la directivamemory.high, iniciando la retención suave y la recolección preventiva en cuanto el script supere los 800 MB.CPUQuota=150%: Garantiza que la tarea utilice como máximo el equivalente a 1,5 núcleos de CPU (150% del tiempo de procesamiento de un núcleo).TasksMax=50: Restringe la cantidad total de hilos y subprocesos simultáneos que el script de Python puede generar en el sistema, evitando ataques de degradación por bombas fork.
En caso de que necesites ejecutar un proceso en segundo plano que permanezca activo incluso después de cerrar la terminal, solo reemplaza la bandera --scope por --unit:
systemd-run --unit=worker-python-transiente \
  -p MemoryMax=2G \
  -p CPUQuota=100% \
  python3 -m app.worker
Puedes monitorear el consumo inmediato de recursos de esta unidad transitoria en tiempo real con el comando de systemd enfocado en métricas de supervisión:
systemd-cgtop
La interfaz de systemd-cgtop muestra de forma dinámica el número de tareas activas, el porcentaje de uso de CPU, la tasa de transferencia de I/O en disco y la asignación de memoria por unidad, permitiéndote validar en la práctica la efectividad de las restricciones configuradas.
¿Cómo crear slices personalizadas en systemd para microservicios en Python?
Cuando trabajas con arquitecturas compuestas por múltiples microservicios, como API en Flask 3.1.3 o Django 6.1.1, workers asíncronos y bases de datos locales, limitar servicios de forma aislada puede no ser suficiente. En muchos escenarios, se requiere agrupar toda una familia de servicios bajo una cuota compartida de infraestructura. Es aquí donde entran las slices (fracciones o capas) de systemd.
Una slice de systemd no es más que un nodo organizativo en el árbol unificado de cgroups v2. Por defecto, Linux organiza la ejecución en tres slices principales: system.slice (para daemons del sistema), user.slice (para sesiones de usuarios conectados) y machine.slice (para máquinas virtuales y contenedores). Crear slices personalizadas nos permite definir prioridades claras en la asignación de hardware.
A continuación se presenta una estructura comparativa que muestra cómo se distribuyen las restricciones entre distintos tipos de cargas de trabajo en un servidor de producción:
| Nombre de la Slice | Perfil del Servicio | Límite de Memoria (MemoryMax) |
Límite de CPU (CPUQuota) |
Prioridad de CPU (CPUWeight) |
|---|---|---|---|---|
infra.slice |
Base de datos PostgreSQL 18.6 | Sin límite estricto (Prioritario) | 400% (4 Cores) | 200 (Alta) |
backend.slice |
API web en Python 3.14.7 | 4 Gigabytes | 200% (2 Cores) | 100 (Normal) |
analytics.slice |
Scripts en lote y reportes | 1.5 Gigabytes | 50% (0.5 Core) | 20 (Baja) |
Para implementar esta arquitectura en la práctica, crea en primer lugar el archivo de definición de la slice en el directorio de configuración del sistema /etc/systemd/system/analytics.slice:
[Unit]
Description=Slice de Recursos para Procesamiento Batch y Analytics
Documentation=https://blog.exemplo.com.br/cgroups-v2-systemd

[Slice]
CPUAccounting=true
MemoryAccounting=true
MemoryMax=1.5G
MemoryHigh=1.2G
CPUQuota=50%
CPUWeight=20
Tras guardar el archivo de la slice, actualiza el gestor de unidades de systemd para que reconozca la nueva configuración:
sudo systemctl daemon-reload
Ahora, cualquier servicio configurado en el sistema se puede asociar explícitamente a esta slice de recursos ajustando el parámetro Slice= en la sección [Service] de su archivo de unidad .service. Observa cómo queda el archivo de servicio para un worker en Python en /etc/systemd/system/worker-analytics.service:
[Unit]
Description=Worker de Reportes y Procesamiento en Lote
After=network.target postgresql.service

[Service]
Type=simple
User=www-data
WorkingDirectory=/var/www/analytics
ExecStart=/var/www/analytics/venv/bin/python main.py
Restart=always
RestartSec=5

# Asociación directa del servicio a la Slice con restricciones
Slice=analytics.slice

[Install]
WantedBy=multi-user.target
Habilita e inicia el servicio para aplicar la jerarquía de inmediato:
sudo systemctl enable --now worker-analytics.service
Con esta estructura configurada, aunque el script de Python para reportes presente una fuga de memoria o intente asignar decenas de gigabytes de forma inadvertida, el límite estricto impuesto por la slice analytics.slice entrará en acción. El proceso del worker se reiniciará de forma transparente sin comprometer la latencia de la API que opera en backend.slice y sin interrumpir el funcionamiento de PostgreSQL.
Para inspeccionar detalladamente cómo systemd está distribuyendo las slices y qué unidades pertenecen a cada nodo jerárquico, utiliza el comando de visualización en árbol:
systemd-cgls
El árbol resultante muestra cada servicio perfectamente asignado a su grupo de control correspondiente, demostrando la previsibilidad y elegancia de la gestión unificada que ofrece cgroups v2 en el Linux moderno.
Conclusión
La migración a la arquitectura unificada de cgroups v2 es uno de los hitos más importantes de la administración moderna de sistemas Linux. Al abandonar los subsistemas fragmentados de v1, el kernel pasó a ofrecer una plataforma increíblemente precisa para el aislamiento y control de recursos computacionales.
Comprender el papel de métricas como memory.max y memory.high, además de aprovechar las abstracciones de systemd —como las unidades transitorias mediante systemd-run y las estructuras jerárquicas con archivos .slice—, permite construir infraestructuras inmunes a bloqueos e interrupciones inesperadas. Ya sea ejecutando microservicios exigentes en Python 3.14.7 o manteniendo bases de datos críticas operando sin fluctuaciones, saber cómo limitar cpu y memoria con cgroups v2 transforma la gestión de servidores en un proceso declarativo, estable y profesional.