Evite travamentos ao limitar cpu e memoria com cgroups v2
Aprenda a limitar cpu e memoria com cgroups v2 no Linux para proteger seus servidores contra travamentos e gargalos. Guia prático com systemd e Python.
Quando uma aplicação em Python 3.14.7 entra em um loop infinito ou um script de processamento em lote tenta carregar um dataset maior que a RAM física disponível, as consequências para o servidor costumam ser catastróficas. Sem isolamento adequado, um único processo descontrolado consome toda a CPU do sistema, estoura a memória swap e provoca o travamento completo do ambiente, exigindo intervenções manuais drásticas. A solução definitiva para manter a estabilidade e a previsibilidade operacional em distribuições modernas é limitar cpu e memoria com cgroups v2, o mecanismo unificado de controle de recursos do kernel Linux.
Historicamente, o gerenciamento de recursos no Linux sofria com a complexidade e a falta de coordenação entre os subsistemas de controle. O cgroups v2 resolve esse impasse ao reorganizar toda a árvore de processos sob uma arquitetura de hierarquia única. Seja para isolar microsserviços rodando no Ubuntu 26.04.1, restringir containers temporários ou proteger bancos de dados como o PostgreSQL 18.6 contra concorrência predatória, dominar as ferramentas do cgroups v2 junto ao systemd é uma competência indispensável para qualquer desenvolvedor ou administrador de sistemas.
Por que o modelo unificado do cgroups v2 substituiu a v1?
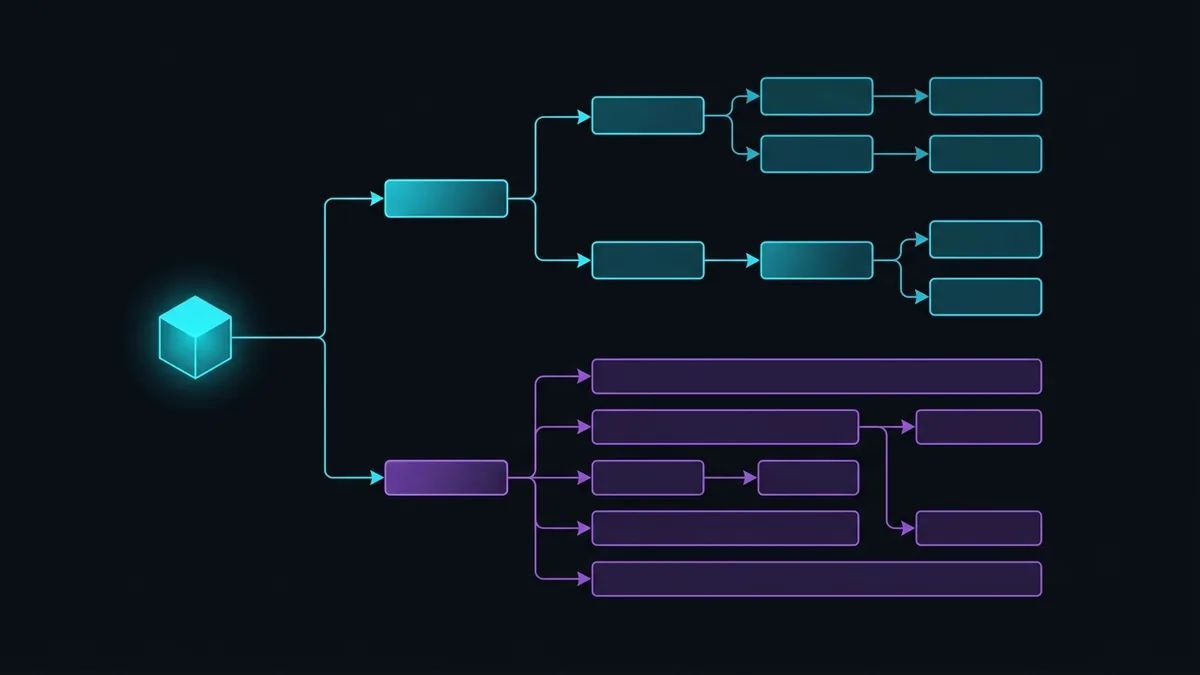
A transição da versão 1 para a versão 2 do cgroups não foi apenas uma simples melhoria incremental, mas sim uma reformulação estrutural profunda no kernel Linux. No cgroups v1, cada subsistema de recurso — como CPU, memória, I/O de disco e rede — possuía sua própria árvore de diretórios independente sob /sys/fs/cgroup. Essa independência criava um problema grave de inconsistência: um mesmo processo podia pertencer a um grupo específico na árvore de CPU, mas estar associado a um grupo completamente diferente na árvore de memória.
Essa falta de unificação gerava condições de corrida, travamentos difíceis de depurar e falhas crônicas no controle de entrada e saída. Por exemplo, quando o kernel tentava aplicar limites de I/O em um processo, ele frequentemente falhava em rastrear quais páginas de memória em cache pertenciam àquele grupo, resultando em gravações em disco descontroladas que ignoravam as restrições impostas. Além disso, o comportamento do OOM Killer (Out Of Memory Killer) no cgroups v1 era imprevisível, muitas vezes eliminando processos críticos do sistema operacional em vez de encerrar apenas a aplicação que estourou a cota.
O cgroups v2 resolveu essa desorganização ao implementar o princípio do modelo de hierarquia unificada. Nessa nova abordagem, cada processo do sistema pertence a exatamente um único nó na árvore do cgroups. A estrutura espelha diretamente a árvore de processos do sistema, garantindo que o controle de CPU, memória, I/O e threads ocorra sob o mesmo contexto hierárquico. Os controladores de recursos são habilitados explicitamente em cada nível através do arquivo de interface cgroup.subtree_control.
Outra inovação crucial do cgroups v2 é a métrica PSI (Pressure Stall Information). O PSI permite que o kernel e os daemons de monitoramento meçam com precisão em tempo real quanto tempo de execução as tarefas estão perdendo devido à falta de CPU, memória ou I/O de disco. Em relação à gestão de memória, a versão 2 introduziu uma distinção clara entre dois limites essenciais:
memory.high: Atua como um limite suave de estrangulamento. Quando o consumo de RAM do grupo ultrapassa esse valor, o processo não é sumariamente interrompido pelo sistema. Em vez disso, o kernel desacelera a alocação de memória e força o processo a realizar a liberação de páginas em cache ou entrar em estado de espera, aplicando um freio preventivo.memory.max: Representa o limite rígido de alocação. Se o grupo atingir este teto e não houver memória física ou espaço de swap recuperável, o OOM Killer é acionado especificamente para aquele grupo de controle, encerrando a tarefa ofensora sem afetar os demais serviços da máquina.
Essa arquitetura integrada garante que a limitação de recursos ocorra de forma previsível e segura, tornando a infraestrutura muito mais resiliente a picos imprevistos de carga.
Como configurar o Linux para limitar cpu e memoria com cgroups v2?
Para verificar se o seu sistema operacional já está operando inteiramente com cgroups v2, basta checar o tipo de sistema de arquivos montado no diretório /sys/fs/cgroup. Em distribuições atuais, como o Debian 13.7 e o Ubuntu 26.04.1, a versão 2 é ativada por padrão na instalação. Executando um comando simples de verificação no terminal, confirme a montagem:
stat -f -c %T /sys/fs/cgroup
Se o retorno for cgroup2fs, a hierarquia unificada está ativa e pronta para uso. Caso contrário, a alteração pode ser configurada adicionando o parâmetro systemd.unified_cgroup_hierarchy=1 na linha de comando do boot loader do GRUB e reiniciando a máquina.
Embora em ambientes de produção o recomendado seja utilizar o gerenciamento integrado via systemd, compreender como interagir diretamente com a interface gráfica pseudo-filesystem do kernel é fundamental para entender o funcionamento interno do mecanismo. No diretório /sys/fs/cgroup, a criação de um novo grupo de controle é equivalente à criação de um simples diretório.
Abaixo está uma demonstração prática de como criar um cgroup manual para limitar cpu e memoria com cgroups v2 em um script de testes:
# Criação do nó hierárquico para a aplicação
sudo mkdir -p /sys/fs/cgroup/meu_servico_teste

# Habilitação dos controladores de CPU e memória
echo "+cpu +memory" | sudo tee /sys/fs/cgroup/cgroup.subtree_control

# Definição do limite máximo de memória para 512 Megabytes (em bytes)
echo "536870912" | sudo tee /sys/fs/cgroup/meu_servico_teste/memory.max

# Definição da cota de CPU (formato: quota período, em microssegundos)
# O valor 50000 100000 limita o uso a 50% de um único núcleo de CPU
echo "50000 100000" | sudo tee /sys/fs/cgroup/meu_servico_teste/cpu.max
Uma vez definidos os arquivos de controle no diretório criado, qualquer processo pode ser movido para dentro desse grupo escrevendo seu PID (Process ID) no arquivo de interface cgroup.procs:
# Anexando o shell atual ao cgroup restrito
echo $$ | sudo tee /sys/fs/cgroup/meu_servico_teste/cgroup.procs
A partir do instante em que o PID é registrado, todos os processos filhos gerados por esse shell herdarão automaticamente as restrições de cota impostas. Se um script Python tentar alocar um array gigante que ultrapasse os 512 MB configurados em memory.max, o OOM Killer do kernel atuará restritamente dentro do grupo meu_servico_teste, mantendo a estabilidade global do sistema intacta.
Como usar o systemd-run para limitar recursos em scripts sem reiniciar a máquina?
Manipular arquivos diretamente dentro do diretório /sys/fs/cgroup durante a execução normal de um servidor não é a prática mais recomendada no ecossistema moderno. Como o systemd atua como o gerenciador primário de init e de cgroups no Linux, criar diretórios manuais pode gerar conflitos de propriedade na árvore do cgroup. Para executar comandos ad-hoc e tarefas pontuais sujeitas a restrições de recursos sem a necessidade de editar arquivos de serviço permanentes, o utilitário systemd-run é a solução perfeita.
O systemd-run cria uma unidade transiente (uma unidade temporária gerenciada diretamente pela memória do systemd) que engloba a execução do comando desejado em um escopo totalmente isolado. Isso é extremamente útil para rotinas de manutenção, pipelines de ciência de dados em Python ou tarefas de manutenção que rodam periodicamente.
A sintaxe para definir limites dinâmicos com systemd-run é direta e intuitiva. Veja abaixo um exemplo real limitando uma tarefa pesada de processamento:
systemd-run --scope \
  -p MemoryMax=1G \
  -p MemoryHigh=800M \
  -p CPUQuota=150% \
  -p TasksMax=50 \
  python3 script_processamento.py
Examinando detalhadamente cada parâmetro aplicado ao comando:
--scope: Informa ao systemd para executar o comando no mesmo contexto de processo atual, em vez de criar um serviço em segundo plano (background daemon).MemoryMax=1G: Mapeia diretamente para a diretivamemory.maxdo cgroups v2, definindo a trava rígida de 1 Gigabyte de memória RAM.MemoryHigh=800M: Mapeia para a diretivamemory.high, iniciando a retenção suave e a coleta de lixo preventiva assim que o script ultrapassar 800 MB.CPUQuota=150%: Garante que a tarefa utilize no máximo o equivalente a 1,5 núcleos de CPU (150% do tempo de processamento de uma CPU).TasksMax=50: Restringe a quantidade total de threads e subprocessos simultâneos que o script Python pode gerar no sistema, evitando ataques de degradação por bombardeio de tarefas (fork bombs).
Caso você precise rodar um processo em segundo plano que permaneça ativo mesmo após o fechamento do terminal atual, basta substituir a flag --scope pela flag --unit:
systemd-run --unit=worker-python-transiente \
  -p MemoryMax=2G \
  -p CPUQuota=100% \
  python3 -m app.worker
Você pode acompanhar o consumo imediato de recursos dessa unidade transiente em tempo real através do comando do systemd voltado a métricas de monitoramento:
systemd-cgtop
A interface do systemd-cgtop exibe dinamicamente o número de tarefas ativas, o percentual de uso de CPU, a taxa de transferência de I/O em disco e a alocação de memória por unidade, permitindo validar na prática a efetividade do estrangulamento configurado.
Como criar slices personalizadas no systemd para microsserviços em Python?
Quando lidamos com arquiteturas compostas por múltiplos microsserviços, como APIs em Flask 3.1.3 ou Django 6.1.1, workers assíncronos e bancos de dados locais, limitar serviços de forma isolada pode não ser suficiente. Em muitos cenários, é necessário agrupar uma família inteira de serviços sob uma cota compartilhada de infraestrutura. É aqui que entram as slices (fatias) do systemd.
Uma slice do systemd nada mais é do que um nó organizacional na árvore unificada de cgroups v2. Por padrão, o Linux organiza a execução em três slices principais: system.slice (para daemons do sistema), user.slice (para sessões de usuários conectados) e machine.slice (para máquinas virtuais e containers). Criar fatias personalizadas nos permite definir prioridades claras de alocação de hardware.
Abaixo está uma estrutura de comparação exibindo como as restrições são distribuídas entre diferentes tipos de carga de trabalho em um servidor de produção:
| Nome da Slice | Perfil do Serviço | Limite de Memória (MemoryMax) |
Limite de CPU (CPUQuota) |
Prioridade de CPU (CPUWeight) |
|---|---|---|---|---|
infra.slice |
Banco de Dados PostgreSQL 18.6 | Sem limite rígido (Prioritário) | 400% (4 Cores) | 200 (Alta) |
backend.slice |
APIs web em Python 3.14.7 | 4 Gigabytes | 200% (2 Cores) | 100 (Normal) |
analytics.slice |
Scripts em lote e relatórios | 1.5 Gigabytes | 50% (0.5 Core) | 20 (Baixa) |
Para implementar essa arquitetura na prática, crie primeiramente o arquivo de definição da slice no diretório de configurações do sistema /etc/systemd/system/analytics.slice:
[Unit]
Description=Fatia de Recursos para Processamento Batch e Analytics
Documentation=https://blog.exemplo.com.br/cgroups-v2-systemd

[Slice]
CPUAccounting=true
MemoryAccounting=true
MemoryMax=1.5G
MemoryHigh=1.2G
CPUQuota=50%
CPUWeight=20
Após salvar o arquivo da slice, atualize o gerenciador de unidades do systemd para reconhecer a nova configuração:
sudo systemctl daemon-reload
Agora, qualquer serviço configurado no sistema pode ser associado explicitamente a essa fatia de recursos ajustando o parâmetro Slice= na seção [Service] do seu arquivo de unidade .service. Veja como fica o arquivo de serviço para um worker em Python em /etc/systemd/system/worker-analytics.service:
[Unit]
Description=Worker de Relatórios e Processamento em Lote
After=network.target postgresql.service

[Service]
Type=simple
User=www-data
WorkingDirectory=/var/www/analytics
ExecStart=/var/www/analytics/venv/bin/python main.py
Restart=always
RestartSec=5

# Associação direta do serviço à Slice com restrições
Slice=analytics.slice

[Install]
WantedBy=multi-user.target
Ative e inicie o serviço para aplicar a hierarquia imediatamente:
sudo systemctl enable --now worker-analytics.service
Com essa estrutura montada, mesmo se o script Python de relatórios encontrar um vazamento de memória ou tentar alocar dezenas de gigaBytes inadvertidamente, o teto rígido imposto pela fatia analytics.slice entra em ação. O processo do worker será reiniciado de forma transparente sem comprometer a latência da API que opera na backend.slice e sem remover o PostgreSQL do ar.
Para inspecionar detalhadamente como o systemd está distribuindo as slices e quais unidades pertencem a cada nó hierárquico, utilize o comando de visualização em árvore:
systemd-cgls
A árvore resultante exibe cada serviço perfeitamente alocado em seu devido grupo de controle, demonstrando a previsibilidade e a elegância da gestão unificada promovida pelo cgroups v2 no Linux moderno.
Conclusão
A migração para a arquitetura unificada do cgroups v2 é um dos marcos mais importantes da administração moderna de sistemas Linux. Ao abandonar os subsistemas fragmentados da v1, o kernel passou a entregar uma plataforma incrivelmente precisa para o isolamento e controle de recursos computacionais.
Compreender o papel de métricas como memory.max e memory.high, além de utilizar as abstrações do systemd — como unidades transientes via systemd-run e fatias hierárquicas via .slice —, permite criar infraestruturas imunes a travamentos inesperados. Seja rodando microsserviços pesados em Python 3.14.7 ou mantendo bancos de dados críticos operando sem oscilação, saber como limitar cpu e memoria com cgroups v2 transforma o gerenciamento de servidores em um processo declarativo, estável e profissional.