Chega de log inútil: como configurar structlog em Python
Aprenda como configurar structlog em Python para gerar logs estruturados em JSON, rastrear requisições e simplificar a observabilidade do seu sistema.
Quando uma aplicação Python falha em produção durante a madrugada, poucas coisas causam tanta frustração quanto abrir a ferramenta de monitoramento e encontrar milhares de linhas de texto puro sem formato definido. Procurar um erro específico em registros no estilo 2026-09-15 14:02:11 ERROR user 482 failed exige expressões regulares complexas e filtros manuais que consomem tempo valioso de diagnóstico. Entender como configurar structlog em Python é o passo decisivo para transformar mensagens de texto desestruturadas em objetos JSON padronizados, ricos em contexto estruturado e prontos para serem ingeridos por agregadores como Datadog, Grafana Loki e Elasticsearch.
Neste guia prático, vou demonstrar como abandonar as limitações do módulo nativo logging, montar uma cadeia de processadores de alto rendimento no Python 3.14.7 e injetar variáveis de contexto dinâmicas em requisições assíncronas sem poluir a regra de negócio do seu projeto.
Por que trocar o logging nativo do Python pelo structlog?
O módulo logging da biblioteca padrão do Python acompanha a linguagem há duas décadas. Ele cumpre bem o papel em scripts simples, mas apresenta deficiências estruturais graves em microsserviços modernos e APIs de alta concorrência. O principal gargalo reside na formatação: o logging nativo trata mensagens como cadeias de caracteres formatadas via interpolação de strings (%s ou f-strings). Quando você precisa anexar o ID de uma transação, o endereço IP do cliente ou o tempo de resposta do banco de dados, essas informações acabam concatenadas no corpo da mensagem.
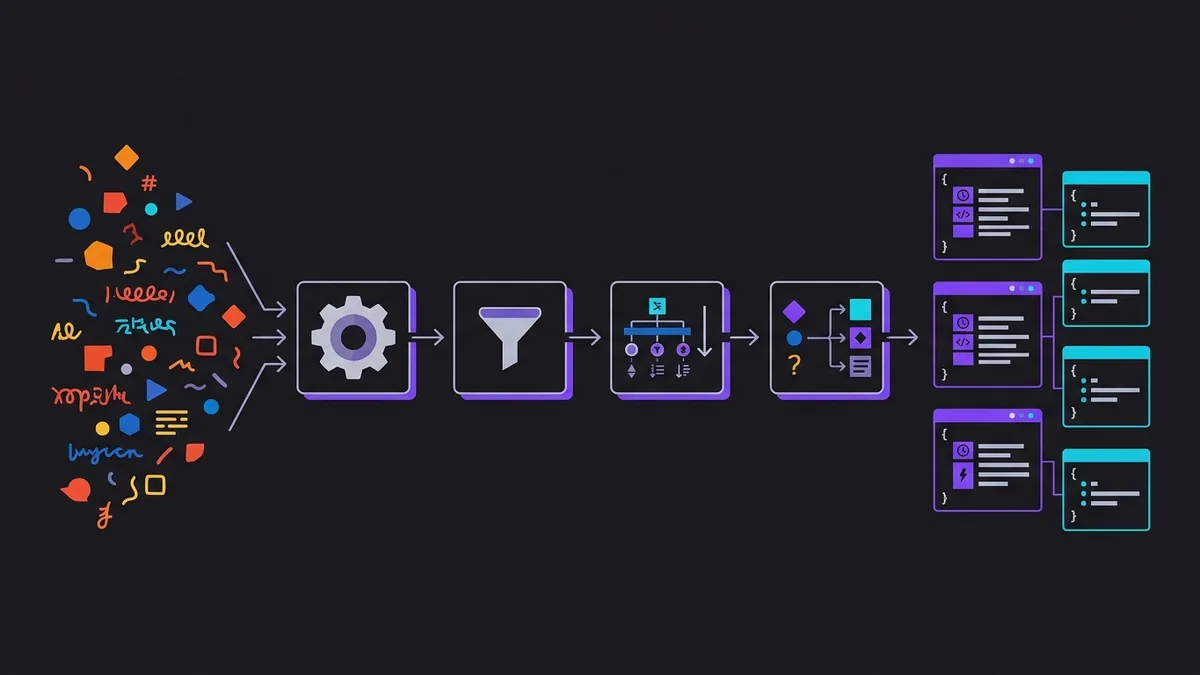
O structlog adota uma arquitetura completamente diferente baseada em dicionários e processadores encadeados. Em vez de construir uma string final no ponto de chamada do código, você passa pares de chave e valor. Cada evento de log atravessa um pipeline de funções puras que transformam, enriquecem e filtram o dicionário até a renderização final.
Principais vantagens da abordagem do structlog:
- Consistência de Tipos: Valores numéricos permanecem como inteiros ou flutuantes e listas permanecem como arrays no JSON gerado, facilitando queries numéricas e agregações.
- Ligação Contextual (Context Binding): É possível anexar parâmetros fixos a uma instância de logger no início de uma requisição e reutilizá-la em todas as funções chamadas posteriormente.
- Isolamento entre Threads e Corrotinas: Suporte nativo a
contextvarsdo Python, garantindo que o ID de correlação de uma requisição assíncrona não vaze para outra execução paralela. - Zero Overhead em Produção: Se o nível de log estiver configurado para
INFO, chamadas de nívelDEBUGsão descartadas no início do pipeline antes de executar processamentos custosos.
Passo a passo: como configurar structlog em Python do zero
Para começar a utilizar o pacote em um ambiente limpo com Python 3.14.7, primeiro realize a instalação da biblioteca via gerenciador de pacotes da sua preferência:
pip install structlog
A configuração do structlog ocorre concentrando a definição da cadeia de processadores no ponto de entrada da aplicação (main.py ou módulo de inicialização). A função structlog.configure() aceita uma lista de processadores executados na ordem exata em que são declarados.
Abaixo está uma implementação base completa e funcional:
import logging
import sys
import structlog

def setup_logging() -> None:
    structlog.configure(
        processors=[
            structlog.contextvars.merge_contextvars,
            structlog.processors.add_log_level,
            structlog.processors.StackInfoRenderer(),
            structlog.dev.set_exc_info,
            structlog.processors.TimeStamper(fmt="iso", utc=True),
            structlog.processors.JSONRenderer(),
        ],
        wrapper_class=structlog.make_filtering_bound_logger(logging.INFO),
        context_class=dict,
        logger_factory=structlog.BytesLoggerFactory(),
        cache_logger_on_first_use=True,
    )

if __name__ == "__main__":
    setup_logging()
    logger = structlog.get_logger()
    logger.info("servico_iniciado", porta=8080, ambiente="producao")
Vamos entender o papel de cada componente dessa cadeia:
merge_contextvars: Extrai variáveis globais cadastradas no contexto assíncrono atual e as injeta no log.add_log_level: Adiciona a chavelevel(comoinfo,errorouwarning) ao dicionário do evento.TimeStamper: Insere o carimbo de data e hora no formato ISO-8601 em tempo UTC estritamente padronizado.JSONRenderer: Converte o dicionário resultante em uma string JSON minificada enviada para a saída padrão (sys.stdout).
Ao executar o script acima, a saída gerada no terminal será um JSON perfeitamente válido:
{"ambiente": "producao", "event": "servico_iniciado", "level": "info", "porta": 8080, "timestamp": "2026-09-15T15:30:00.000000Z"}
Como integrar o structlog com o módulo logging padrão do Python?
Em um ecossistema real de desenvolvimento, sua aplicação consome bibliotecas de terceiros como SQLAlchemy 2.0, FastAPI, Uvicorn e HTTPX. Essas ferramentas utilizam internamente o módulo logging nativo do Python. Se você configurar apenas o structlog, os logs das dependências continuarão sendo emitidos em texto puro desformatado, quebrando a padronização dos seus arquivos de saída.
A solução é redirecionar todo o tráfego do logging padrão para o pipeline do structlog. Para isso, criamos um manipulador (Handler) customizado e conectamos as duas bibliotecas.
A tabela abaixo resume as responsabilidades nessa arquitetura de integração:
| Componente | Função no Pipeline Integrado |
|---|---|
| Standard Logging | Captura eventos de bibliotecas externas (ex: SQLAlchemy, Uvicorn) |
| ProcessorFormatter | Converte o LogRecord nativo no dicionário interno do structlog |
| Structlog Processors | Aplica timestamp, contexto e formatação em JSON em todos os eventos |
| Root Logger Handler | Imprime o resultado final consolidado na saída do sistema (stdout) |
Veja a implementação prática dessa ponte de integração no código Python abaixo:
import logging
import sys
import structlog

def configure_unified_logging(log_level: str = "INFO") -> None:
    shared_processors = [
        structlog.contextvars.merge_contextvars,
        structlog.stdlib.add_logger_name,
        structlog.stdlib.add_log_level,
        structlog.processors.TimeStamper(fmt="iso", utc=True),
        structlog.processors.StackInfoRenderer(),
    ]

    structlog.configure(
        processors=shared_processors + [
            structlog.stdlib.ProcessorFormatter.wrap_for_formatter,
        ],
        logger_factory=structlog.stdlib.LoggerFactory(),
        wrapper_class=structlog.stdlib.BoundLogger,
        cache_logger_on_first_use=True,
    )

    formatter = structlog.stdlib.ProcessorFormatter(
        foreign_pre_chain=shared_processors,
        processors=[
            structlog.stdlib.ProcessorFormatter.remove_processors_meta,
            structlog.processors.JSONRenderer(),
        ],
    )

    handler = logging.StreamHandler(sys.stdout)
    handler.setFormatter(formatter)

    root_logger = logging.getLogger()
    root_logger.handlers.clear()
    root_logger.addHandler(handler)
    root_logger.setLevel(log_level)

# Exemplo de uso conjunto
configure_unified_logging()

# Log emitido via structlog
log = structlog.get_logger("app.pedidos")
log.info("processando_pagamento", valor=149.90, moeda="BRL")

# Log emitido por biblioteca tradicional capturado com sucesso
native_log = logging.getLogger("sqlalchemy.engine")
native_log.warning("conexao_lenta_detectada")
Com essa estrutura, tanto as chamadas diretas do seu código quanto as mensagens de aviso emitidas pelo banco de dados passam pela mesma formatação centralizada em JSON.
Como adicionar contexto e rastreamento de requisições nos logs?
Um dos recursos mais poderosos ao estruturar logs em aplicações Web é a capacidade de rastrear a jornada de uma requisição através de múltiplos métodos e camadas de serviços sem precisar repassar parâmetros manualmente em cada função.
O structlog oferece o módulo structlog.contextvars para gerenciamento seguro de estado contextual em ambientes assíncronos baseados em asyncio.
Imagine um middleware em uma API FastAPI ou Starlette que captura o cabeçalho X-Request-ID ou gera um UUID para cada chamada recebida. Podemos associar esse identificador ao contexto no início da requisição:
import asyncio
import uuid
import structlog

# Configuração prévia do structlog omitida para fins de brevidade
logger = structlog.get_logger()

async def processar_item(item_id: str) -> None:
    # Este log herdará automaticamente o request_id e o user_id do contexto
    logger.info("validando_estoque", item_id=item_id)
    await asyncio.sleep(0.05)
    logger.info("item_reservado", item_id=item_id)

async def handle_request(user_id: str) -> None:
    # Limpa contextos residuais e vincula novas variáveis à corrotina atual
    structlog.contextvars.clear_contextvars()
    structlog.contextvars.bind_contextvars(
        request_id=str(uuid.uuid4()),
        user_id=user_id,
    )

    logger.info("requisicao_recebida")
    await processar_item("prod-982")
    logger.info("requisicao_finalizada")

if __name__ == "__main__":
    asyncio.run(handle_request(user_id="usr_5501"))
Ao executar a função handle_request, todas as chamadas logger.info() dentro de processar_item imprimirão os campos request_id e user_id no JSON sem que você precise declará-los novamente. Essa rastreabilidade ponta a ponta é fundamental para depurar falhas em arquiteturas distribuídas.
Como formatar logs para desenvolvimento local e produção?
Embora o formato JSON seja ideal para parsing automático em servidores e sistemas de monitoramento, ele é desconfortável de ler diretamente no terminal do seu ambiente de desenvolvimento local. Uma boa prática de engenharia é adaptar a renderização com base no ambiente de execução.
Podemos criar uma alternância simples checando uma variável de ambiente como ENVIRONMENT:
- Em desenvolvimento (
development): Utilizamosstructlog.dev.ConsoleRenderer(), que exibe os logs coloridos, alinhados e legíveis para humanos. - Em produção (
production): Utilizamosstructlog.processors.JSONRenderer(), garantindo máxima velocidade de serialização e compatibilidade com agregadores.
Observe a implementação dessa lógica condicional:
import os
import sys
import structlog

def get_processors(is_development: bool):
    base_processors = [
        structlog.contextvars.merge_contextvars,
        structlog.processors.add_log_level,
        structlog.processors.TimeStamper(fmt="%Y-%m-%d %H:%M:%S" if is_development else "iso"),
    ]

    if is_development:
        # Formatação amigável para terminal local
        return base_processors + [
            structlog.dev.ConsoleRenderer(colors=True)
        ]
    else:
        # Formatação otimizada em JSON para produção
        return base_processors + [
            structlog.processors.StackInfoRenderer(),
            structlog.processors.format_exc_info,
            structlog.processors.JSONRenderer()
        ]

env = os.getenv("ENVIRONMENT", "development").lower()
is_dev = env == "development"

structlog.configure(
    processors=get_processors(is_development=is_dev),
    wrapper_class=structlog.make_filtering_bound_logger(20),
)

log = structlog.get_logger()
log.info("banco_dados_conectado", host="localhost", pool_size=10)
No modo de desenvolvimento, em vez de uma string JSON compacta, você verá uma linha elegante com destaque de cores no terminal:
2026-09-15 15:30:00 [info ] banco_dados_conectado host=localhost pool_size=10
Conclusão
Dominar como configurar structlog em Python eleva o patamar de maturidade dos seus projetos de software. A transição de arquivos de texto genéricos para um sistema de logs estruturados em JSON elimina gincanas durante o diagnóstico de erros, reduz drasticamente o tempo médio de reparo (MTTR) e integra perfeitamente seus microsserviços com as principais ferramentas de observabilidade do mercado.
Ao adotar a cadeia de processadores unificada, o suporte a contextvars para rastreamento de requisições e a alternância entre renderização de terminal e JSON, sua equipe ganha visibilidade total sobre o comportamento da aplicação sem comprometer o desempenho ou a organização do código.