No más logs inútiles: cómo configurar structlog en Python
Aprende cómo configurar structlog en Python para generar logs estructurados en JSON, rastrear peticiones y simplificar la observabilidad de tus sistemas.
Cuando una aplicación de Python falla en producción durante la madrugada, pocas cosas causan tanta frustración como abrir la herramienta de monitoreo y encontrar miles de líneas de texto plano sin un formato definido. Buscar un error específico en registros al estilo 2026-09-15 14:02:11 ERROR user 482 failed exige expresiones regulares complejas y filtros manuales que consumen tiempo valioso de diagnóstico. Entender cómo configurar structlog en Python es el paso decisivo para transformar mensajes de texto no estructurados en objetos JSON estandarizados, ricos en contexto estructurado y listos para ser ingeridos por agregadores como Datadog, Grafana Loki y Elasticsearch.
En esta guía práctica, te mostraré cómo abandonar las limitaciones del módulo nativo logging, construir una cadena de procesadores de alto rendimiento en Python 3.14.7 e inyectar variables de contexto dinámicas en peticiones asíncronas sin ensuciar la lógica de negocio de tu proyecto.
¿Por qué reemplazar el logging nativo de Python por structlog?
El módulo logging de la biblioteca estándar de Python ha acompañado al lenguaje durante dos décadas. Cumple bien su función en scripts sencillos, pero presenta deficiencias estructurales graves en microservicios modernos y APIs de alta concurrencia. El principal cuello de botella reside en el formateo: el logging nativo trata los mensajes como cadenas de caracteres formateadas mediante interpolación de strings (%s o f-strings). Cuando necesitas adjuntar el ID de una transacción, la dirección IP del cliente o el tiempo de respuesta de la base de datos, esa información termina concatenada en el cuerpo del mensaje.
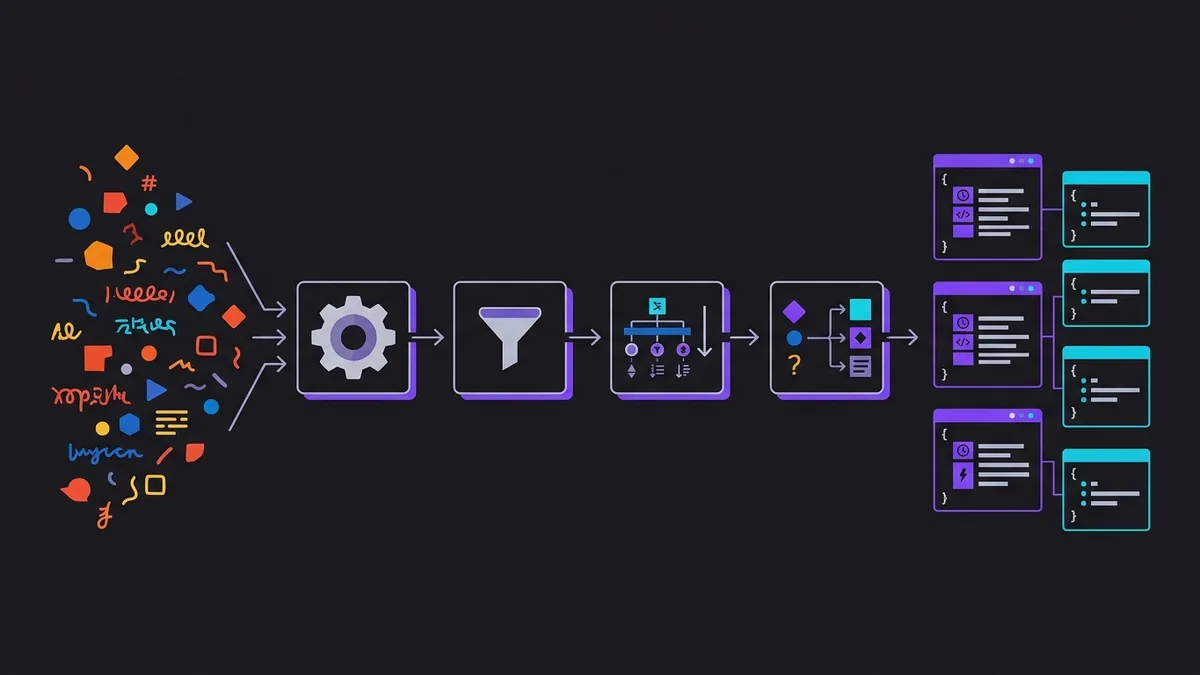
structlog adopta una arquitectura completamente diferente basada en diccionarios y procesadores encadenados. En lugar de construir una string final en el punto de llamada del código, pasas pares de clave y valor. Cada evento de log atraviesa un pipeline de funciones puras que transforman, enriquecen y filtran el diccionario hasta la renderización final.
Principales ventajas del enfoque de structlog:
- Consistencia de Tipos: Los valores numéricos permanecen como enteros o flotantes y las listas permanecen como arreglos en el JSON generado, lo que facilita consultas numéricas y agregaciones.
- Enlace Contextual (Context Binding): Es posible adjuntar parámetros fijos a una instancia de logger al inicio de una petición y reutilizarla en todas las funciones llamadas posteriormente.
- Aislamiento entre Hilos y Corrutinas: Soporte nativo para
contextvarsde Python, garantizando que el ID de correlación de una petición asíncrona no se filtre a otra ejecución paralela. - Cero Overhead en Producción: Si el nivel de log está configurado en
INFO, las llamadas de nivelDEBUGse descartan al inicio del pipeline antes de ejecutar procesamientos costosos.
Paso a paso: cómo configurar structlog en Python desde cero
Para comenzar a utilizar el paquete en un entorno limpio con Python 3.14.7, primero realiza la instalación de la biblioteca mediante el gestor de paquetes de tu preferencia:
pip install structlog
La configuración de structlog se realiza concentrando la definición de la cadena de procesadores en el punto de entrada de la aplicación (main.py o módulo de inicialización). La función structlog.configure() acepta una lista de procesadores ejecutados en el orden exacto en el que son declarados.
A continuación se presenta una implementación base completa y funcional:
import logging
import sys
import structlog

def setup_logging() -> None:
    structlog.configure(
        processors=[
            structlog.contextvars.merge_contextvars,
            structlog.processors.add_log_level,
            structlog.processors.StackInfoRenderer(),
            structlog.dev.set_exc_info,
            structlog.processors.TimeStamper(fmt="iso", utc=True),
            structlog.processors.JSONRenderer(),
        ],
        wrapper_class=structlog.make_filtering_bound_logger(logging.INFO),
        context_class=dict,
        logger_factory=structlog.BytesLoggerFactory(),
        cache_logger_on_first_use=True,
    )

if __name__ == "__main__":
    setup_logging()
    logger = structlog.get_logger()
    logger.info("servico_iniciado", porta=8080, ambiente="producao")
Vamos a entender el rol de cada componente de esta cadena:
merge_contextvars: Extrae variables globales registradas en el contexto asíncrono actual y las inyecta en el log.add_log_level: Agrega la clavelevel(comoinfo,errorowarning) al diccionario del evento.TimeStamper: Inserta la marca de fecha y hora en formato ISO-8601 en tiempo UTC estrictamente estandarizado.JSONRenderer: Convierte el diccionario resultante en una cadena JSON minificada enviada a la salida estándar (sys.stdout).
Al ejecutar el script anterior, la salida generada en la terminal será un JSON perfectamente válido:
{"ambiente": "producao", "event": "servico_iniciado", "level": "info", "porta": 8080, "timestamp": "2026-09-15T15:30:00.000000Z"}
¿Cómo integrar structlog con el módulo logging estándar de Python?
En un ecosistema real de desarrollo, tu aplicación consume bibliotecas de terceros como SQLAlchemy 2.0, FastAPI, Uvicorn y HTTPX. Estas herramientas utilizan internamente el módulo logging nativo de Python. Si solo configuras structlog, los logs de las dependencias continuarán emitiéndose en texto plano sin formato, rompiendo la estandarización de tus archivos de salida.
La solución consiste en redirigir todo el tráfico del logging estándar hacia el pipeline de structlog. Para ello, creamos un manejador (Handler) personalizado y conectamos ambas bibliotecas.
La siguiente tabla resume las responsabilidades en esta arquitectura de integración:
| Componente | Función en el Pipeline Integrado |
|---|---|
| Standard Logging | Captura eventos de bibliotecas externas (ej: SQLAlchemy, Uvicorn) |
| ProcessorFormatter | Convierte el LogRecord nativo en el diccionario interno de structlog |
| Structlog Processors | Aplica timestamp, contexto y formateo en JSON en todos los eventos |
| Root Logger Handler | Imprime el resultado final consolidado en la salida del sistema (stdout) |
Mira la implementación práctica de este puente de integración en el siguiente código de Python:
import logging
import sys
import structlog

def configure_unified_logging(log_level: str = "INFO") -> None:
    shared_processors = [
        structlog.contextvars.merge_contextvars,
        structlog.stdlib.add_logger_name,
        structlog.stdlib.add_log_level,
        structlog.processors.TimeStamper(fmt="iso", utc=True),
        structlog.processors.StackInfoRenderer(),
    ]

    structlog.configure(
        processors=shared_processors + [
            structlog.stdlib.ProcessorFormatter.wrap_for_formatter,
        ],
        logger_factory=structlog.stdlib.LoggerFactory(),
        wrapper_class=structlog.stdlib.BoundLogger,
        cache_logger_on_first_use=True,
    )

    formatter = structlog.stdlib.ProcessorFormatter(
        foreign_pre_chain=shared_processors,
        processors=[
            structlog.stdlib.ProcessorFormatter.remove_processors_meta,
            structlog.processors.JSONRenderer(),
        ],
    )

    handler = logging.StreamHandler(sys.stdout)
    handler.setFormatter(formatter)

    root_logger = logging.getLogger()
    root_logger.handlers.clear()
    root_logger.addHandler(handler)
    root_logger.setLevel(log_level)

# Ejemplo de uso conjunto
configure_unified_logging()

# Log emitido mediante structlog
log = structlog.get_logger("app.pedidos")
log.info("processando_pagamento", valor=149.90, moeda="BRL")

# Log emitido por biblioteca tradicional capturado con éxito
native_log = logging.getLogger("sqlalchemy.engine")
native_log.warning("conexao_lenta_detectada")
Con esta estructura, tanto las llamadas directas de tu código como los mensajes de advertencia emitidos por la base de datos pasan por el mismo formateo centralizado en JSON.
¿Cómo agregar contexto y rastreo de peticiones en los logs?
Uno de los recursos más potentes al estructurar logs en aplicaciones Web es la capacidad de rastrear la trayectoria de una petición a través de múltiples métodos y capas de servicio sin necesidad de pasar parámetros manualmente en cada función.
structlog ofrece el módulo structlog.contextvars para la gestión segura de estado contextual en entornos asíncronos basados en asyncio.
Imagina un middleware en una API de FastAPI o Starlette que captura el encabezado X-Request-ID o genera un UUID para cada llamada recibida. Podemos asociar este identificador al contexto al inicio de la petición:
import asyncio
import uuid
import structlog

# Configuración previa de structlog omitida por brevedad
logger = structlog.get_logger()

async def processar_item(item_id: str) -> None:
    # Este log heredará automáticamente el request_id y el user_id del contexto
    logger.info("validando_estoque", item_id=item_id)
    await asyncio.sleep(0.05)
    logger.info("item_reservado", item_id=item_id)

async def handle_request(user_id: str) -> None:
    # Limpia contextos residuales y vincula nuevas variables a la corrutina actual
    structlog.contextvars.clear_contextvars()
    structlog.contextvars.bind_contextvars(
        request_id=str(uuid.uuid4()),
        user_id=user_id,
    )

    logger.info("requisicao_recebida")
    await processar_item("prod-982")
    logger.info("requisicao_finalizada")

if __name__ == "__main__":
    asyncio.run(handle_request(user_id="usr_5501"))
Al ejecutar la función handle_request, todas las llamadas logger.info() dentro de processar_item imprimirán los campos request_id y user_id en el JSON sin que tengas que declararlos nuevamente. Esta trazabilidad de extremo a extremo es fundamental para depurar fallas en arquitecturas distribuidas.
¿Cómo formatear logs para desarrollo local y producción?
Aunque el formato JSON es ideal para el procesamiento automático en servidores y sistemas de monitoreo, resulta incómodo de leer directamente en la terminal de tu entorno de desarrollo local. Una buena práctica de ingeniería es adaptar la renderización según el entorno de ejecución.
Podemos crear una alternancia sencilla verificando una variable de entorno como ENVIRONMENT:
- En desarrollo (
development): Utilizamosstructlog.dev.ConsoleRenderer(), que muestra los logs con colores, alineados y legibles para humanos. - En producción (
production): Utilizamosstructlog.processors.JSONRenderer(), garantizando la máxima velocidad de serialización y compatibilidad con agregadores.
Observa la implementación de esta lógica condicional:
import os
import sys
import structlog

def get_processors(is_development: bool):
    base_processors = [
        structlog.contextvars.merge_contextvars,
        structlog.processors.add_log_level,
        structlog.processors.TimeStamper(fmt="%Y-%m-%d %H:%M:%S" if is_development else "iso"),
    ]

    if is_development:
        # Formateo amigable para terminal local
        return base_processors + [
            structlog.dev.ConsoleRenderer(colors=True)
        ]
    else:
        # Formateo optimizado en JSON para producción
        return base_processors + [
            structlog.processors.StackInfoRenderer(),
            structlog.processors.format_exc_info,
            structlog.processors.JSONRenderer()
        ]

env = os.getenv("ENVIRONMENT", "development").lower()
is_dev = env == "development"

structlog.configure(
    processors=get_processors(is_development=is_dev),
    wrapper_class=structlog.make_filtering_bound_logger(20),
)

log = structlog.get_logger()
log.info("banco_dados_conectado", host="localhost", pool_size=10)
En el modo de desarrollo, en lugar de una cadena JSON compacta, verás una línea elegante resaltada con colores en la terminal:
2026-09-15 15:30:00 [info ] banco_dados_conectado host=localhost pool_size=10
Conclusión
Dominar cómo configurar structlog en Python eleva el nivel de madurez de tus proyectos de software. La transición de archivos de texto genéricos a un sistema de logs estructurados en JSON elimina complicaciones durante el diagnóstico de errores, reduce drásticamente el tiempo medio de reparación (MTTR) e integra perfectamente tus microservicios con las principales herramientas de observabilidad del mercado.
Al adoptar la cadena de procesadores unificada, el soporte a contextvars para el rastreo de peticiones y la alternancia entre la renderización de terminal y JSON, tu equipo gana visibilidad total sobre el comportamiento de la aplicación sin comprometer el rendimiento ni la organización del código.